A cadeia de suprimentos de software agora é um problema de movimento lateral.
Em 21 de outubro, atacantes lançaram uma versão maliciosa do LiteLLM, uma biblioteca popular do Python com cerca de 23 milhões de downloads semanais. A atualização foi distribuída através do próprio sistema de publicação do projeto, tanto para o PyPI quanto para suas imagens Docker oficiais.
Qualquer pessoa que verificasse a tag de origem oficial no GitHub não encontraria nada de errado, pois os arquivos maliciosos nunca a modificaram.
O lançamento envenenado foi o último recurso do ataque. A análise da causa raiz feita pela LiteLLM apontou que o problema começou com uma chave de administrador que foi acidentalmente enviada para um repositório público em maio. Essa chave abriu uma plataforma de agentes interna, que continha um token do GitHub pertencente ao proprietário da organização. A partir daí, o atacante usou fluxos de trabalho de CI para obter mais tokens. Em seguida, eles direcionaram o pipeline de lançamento para um repositório semelhante.
Este é o mais recente de uma série de incidentes semelhantes ocorridos este ano. Em maio, um grupo identificado por pesquisadores como TeamPCP abusou do pipeline CI/CD do TanStack para publicar 84 versões maliciosas de pacotes sob a identidade npm confiável do projeto. Em agosto, a campanha ChainDrop usou credenciais roubadas para se espalhar por centenas de pacotes npm, muitos deles com procedência legítima.
Em todos os casos, o software confiável tornou-se uma via de ataque, embora os controles ao seu redor parecessem funcionar corretamente. Uma vez que um código malicioso consegue se infiltrar em um ambiente confiável, para onde ele pode ir em seguida? Um executor de compilação pode conter credenciais de nuvem ou permissões de publicação, e um serviço interno pode se conectar a sistemas que seus chamadores não podem acessar diretamente.
É por isso que a segurança da cadeia de suprimentos de software agora precisa ser tratada tanto como um problema de movimento lateral quanto como um problema de dependência.
O pacote é apenas o primeiro passo.
Quando um componente de terceiros se torna uma preocupação de segurança, as equipes naturalmente começam analisando o próprio componente:
- É vulnerável?
- Foi modificado?
- Onde está sendo executado?
- Existe uma versão segura?
Essas perguntas são importantes, mas descrevem apenas o ponto de partida. Um pacote comprometido, em execução dentro de uma máquina de desenvolvedor ou ambiente de compilação, pode repentinamente se encontrar próximo a credenciais de controle de versão, tokens de publicação, identidades na nuvem, acesso ao Kubernetes, APIs internas e caminhos de rede para outros sistemas.
Nesse ponto, o pacote já cumpriu a parte importante, obtendo execução dentro de algo confiável. O ambiente determina o que acontece a seguir.
As equipes costumam visualizar o caminho do ataque como uma linha reta que vai de um pacote malicioso a um aplicativo comprometido. É mais útil rastrear todo o percurso: o pacote malicioso chega a um ambiente confiável, obtém as credenciais e o acesso disponíveis ali e os utiliza para alcançar outros sistemas.
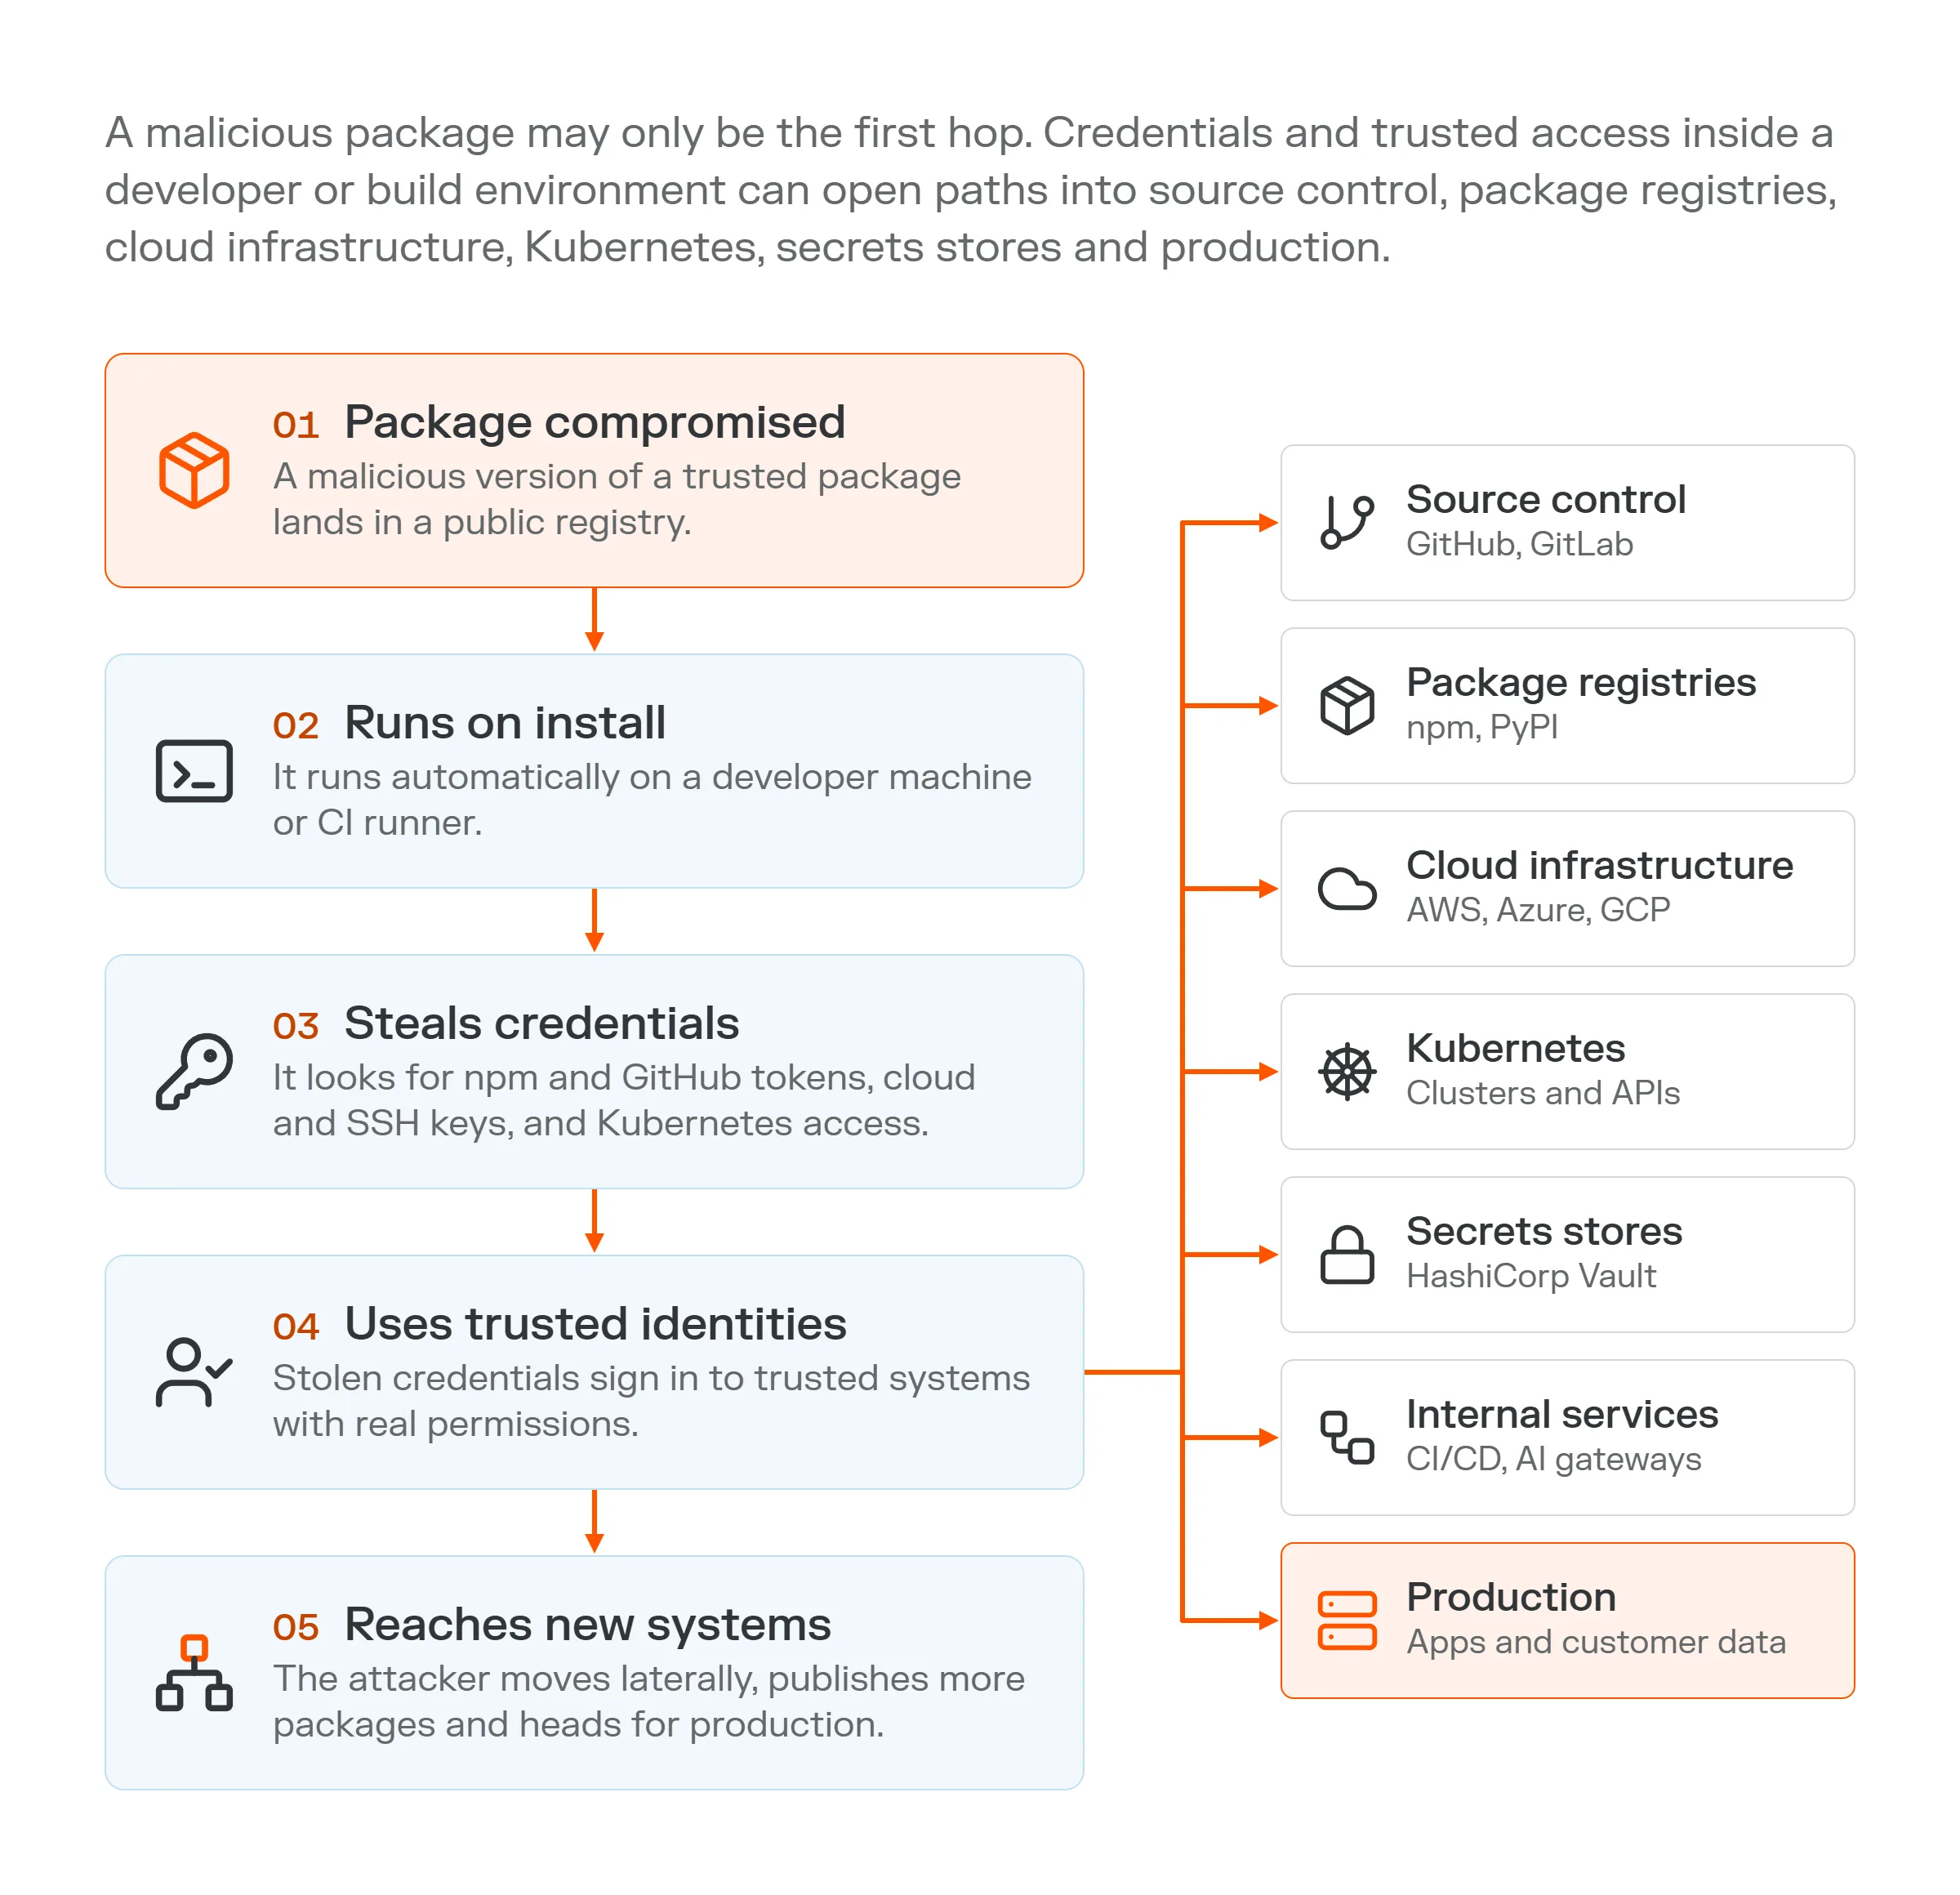
Um pacote malicioso pode ser apenas o primeiro salto. As credenciais e o acesso confiável dentro de um ambiente de desenvolvimento ou de compilação
podem criar caminhos para o controle de versão, registros de pacotes, infraestrutura em nuvem, Kubernetes, armazenamentos de segredos e produção.
Duas empresas podem executar o mesmo pacote de software comprometido e obter resultados muito diferentes. Em um determinado ambiente, o código malicioso pode não ter para onde ir. Em outro caso, pode estar sendo executado em conjunto com credenciais robustas e ampla conectividade interna.
O pacote fornece o ponto de partida. O ambiente determina o raio da explosão.
O risco que se esconde no meio.
As discussões sobre segurança geralmente se concentram nas duas extremidades da cadeia de suprimentos de software: o componente de terceiros que pode ser comprometido e o sistema de produção que queremos proteger. Mas há muita coisa entre eles.
Repositórios de artefatos, proxies de pacotes, caches de CI, plataformas de compilação, ferramentas internas de desenvolvimento, gateways de IA, serviços de segredos e outras infraestruturas compartilhadas conectam diferentes partes dos ambientes de desenvolvimento e produção. As equipes costumam tratar esses sistemas como infraestrutura, mas eles também representam barreiras de segurança.
Um serviço compartilhado pode ser acessível por diversos ambientes. Pode conter credenciais, armazenar dados que outras cargas de trabalho usarão posteriormente ou conectar-se a sistemas que seus chamadores não podem acessar diretamente. Uma maneira útil de pensar nesses sistemas é como intermediários. Eles executam tarefas em nome de outras cargas de trabalho, o que pode estender o alcance de um solicitante além do próprio corretor.
A plataforma de agentes interna da LiteLLM é um exemplo claro disso. Ele existia para abrir solicitações de pull request, portanto, continha um token do GitHub. Esse token pertencia ao proprietário de uma organização, portanto, quem controlava a plataforma obtinha acesso em nível de proprietário a todos os repositórios da empresa.
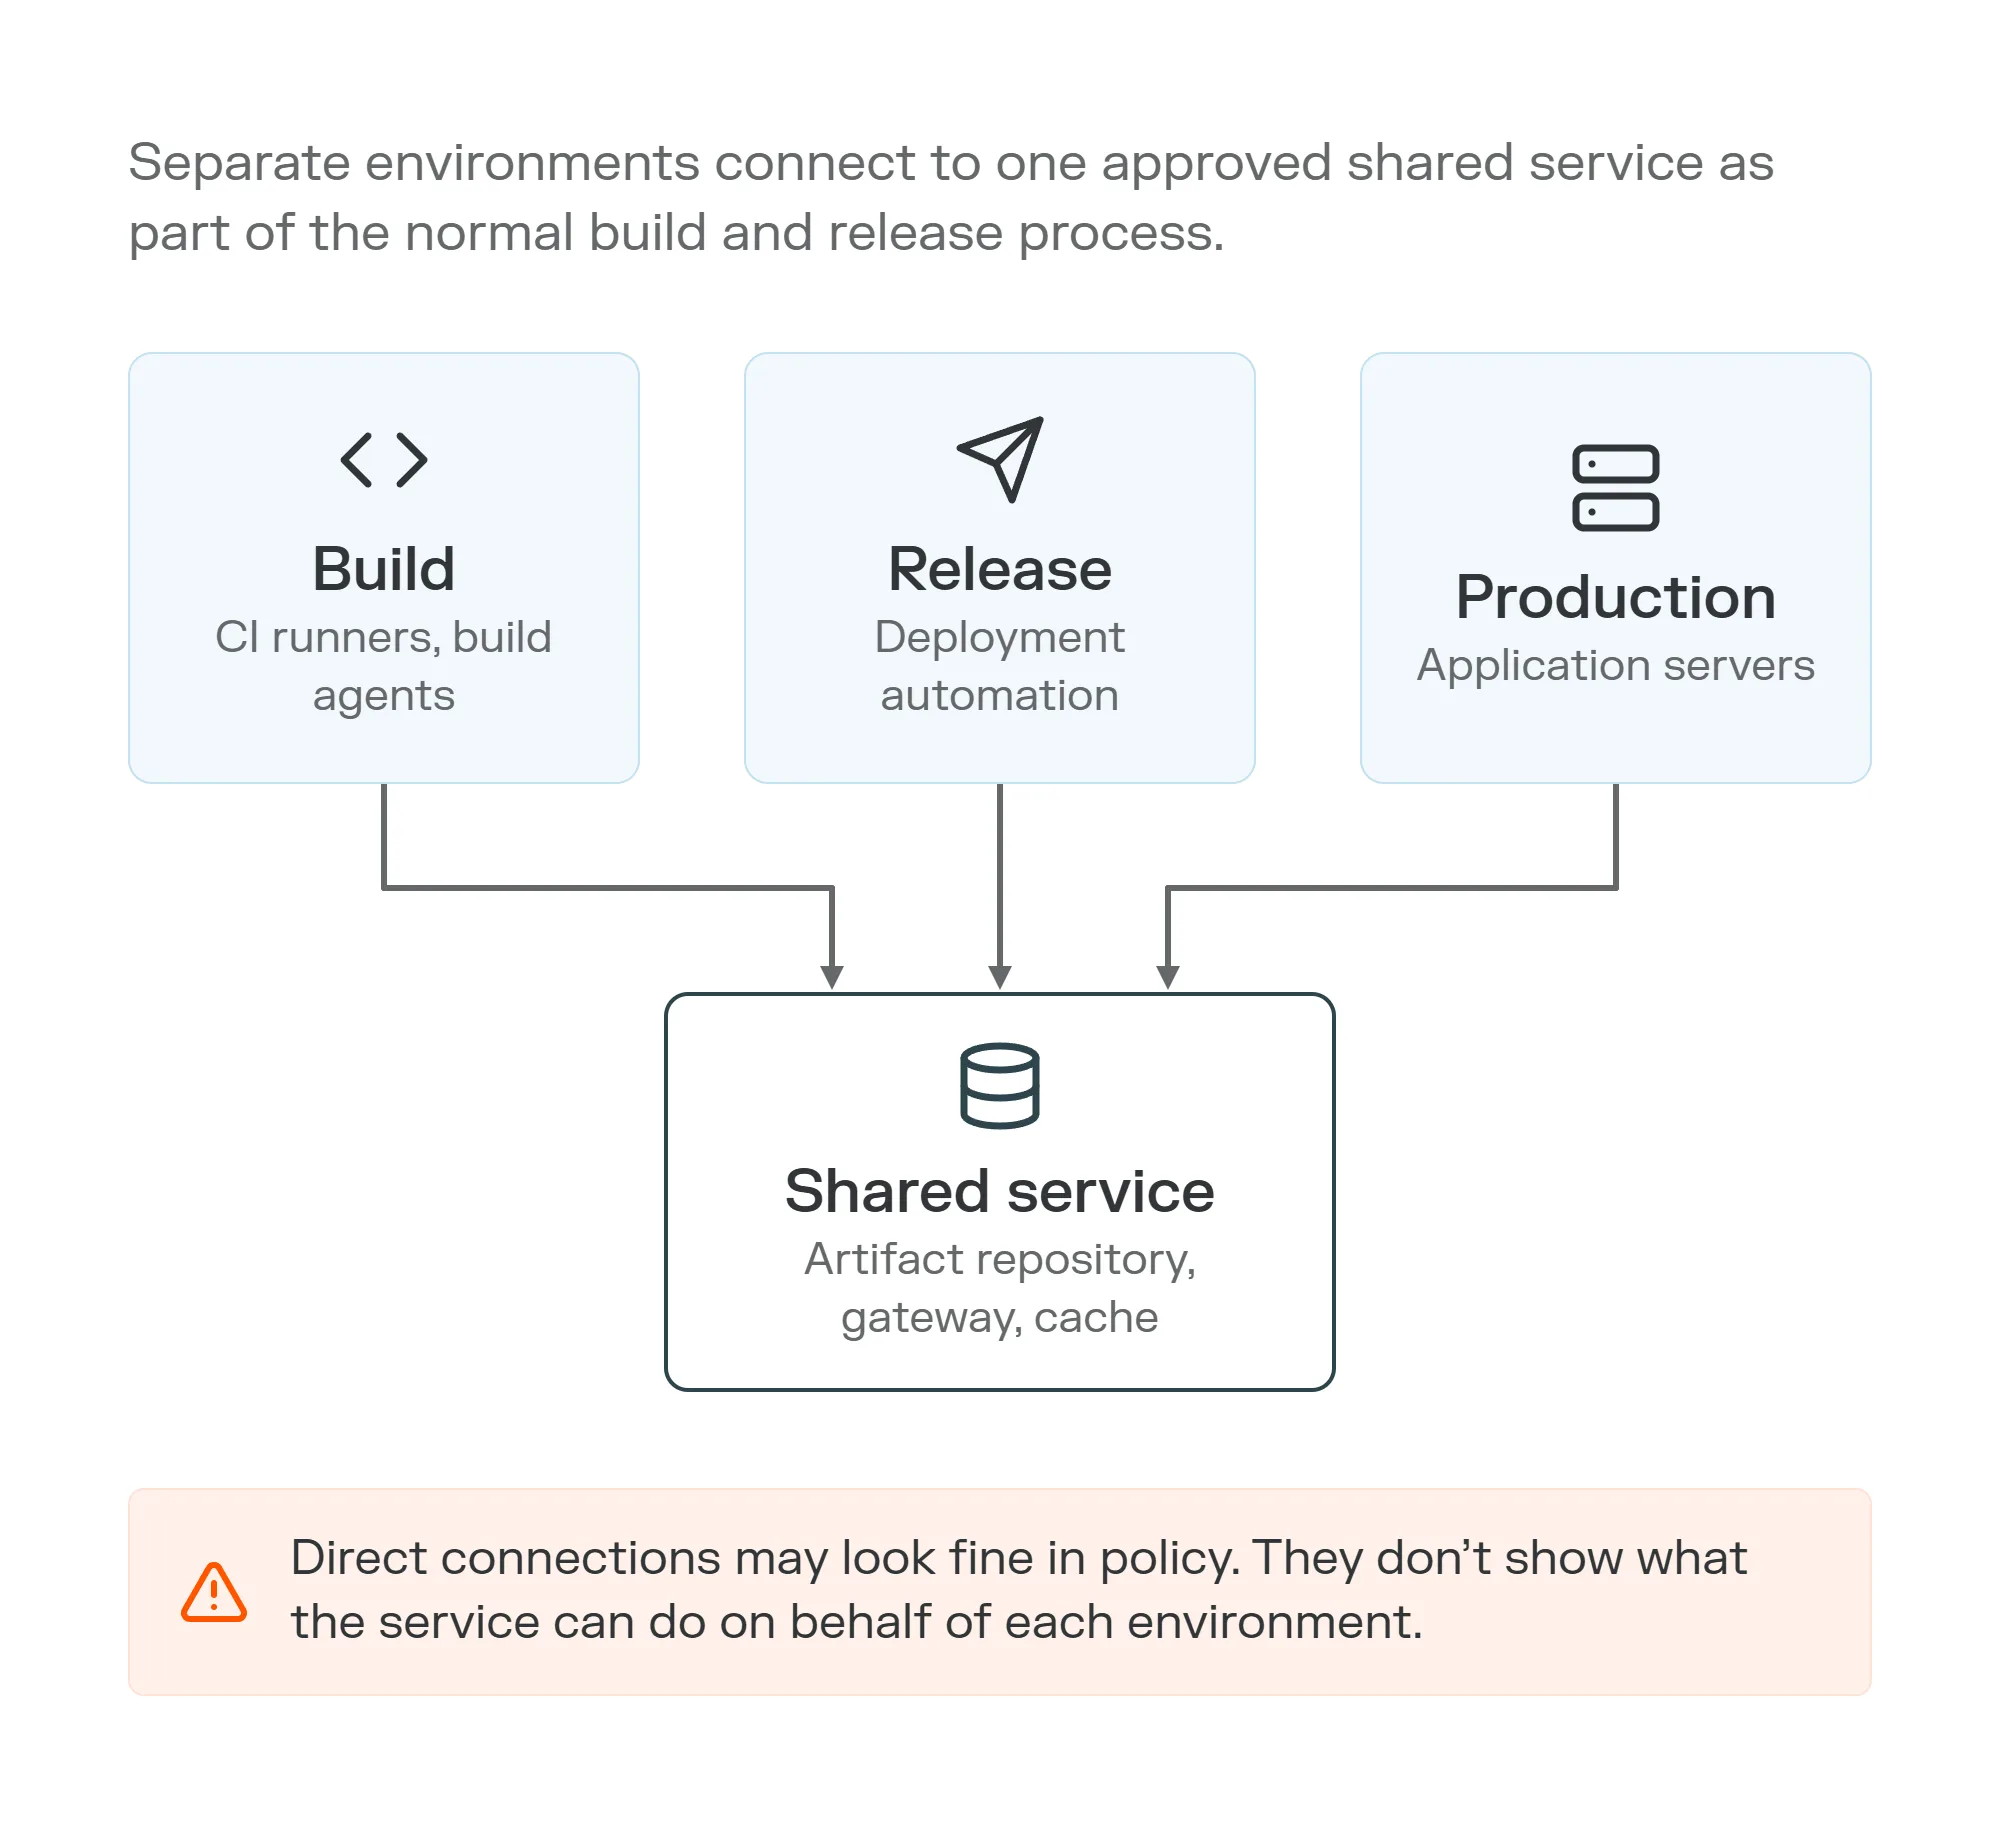
. As etapas de compilação, lançamento e produção possuem links aprovados para um serviço compartilhado. Em teoria, eles parecem bem separados.
Do ponto de vista das políticas, nada parece incomum: um ambiente de compilação se conecta a um repositório de artefatos, um fluxo de trabalho de lançamento se conecta ao mesmo repositório e a produção recupera artefatos dele. Todas as conexões podem ser esperadas e aprovadas.
O problema é que a conectividade direta não mostra a relação de confiança completa. Não nos informa o que o serviço compartilhado pode fazer, qual estado ele mantém ou para onde ele pode se comunicar em seguida.
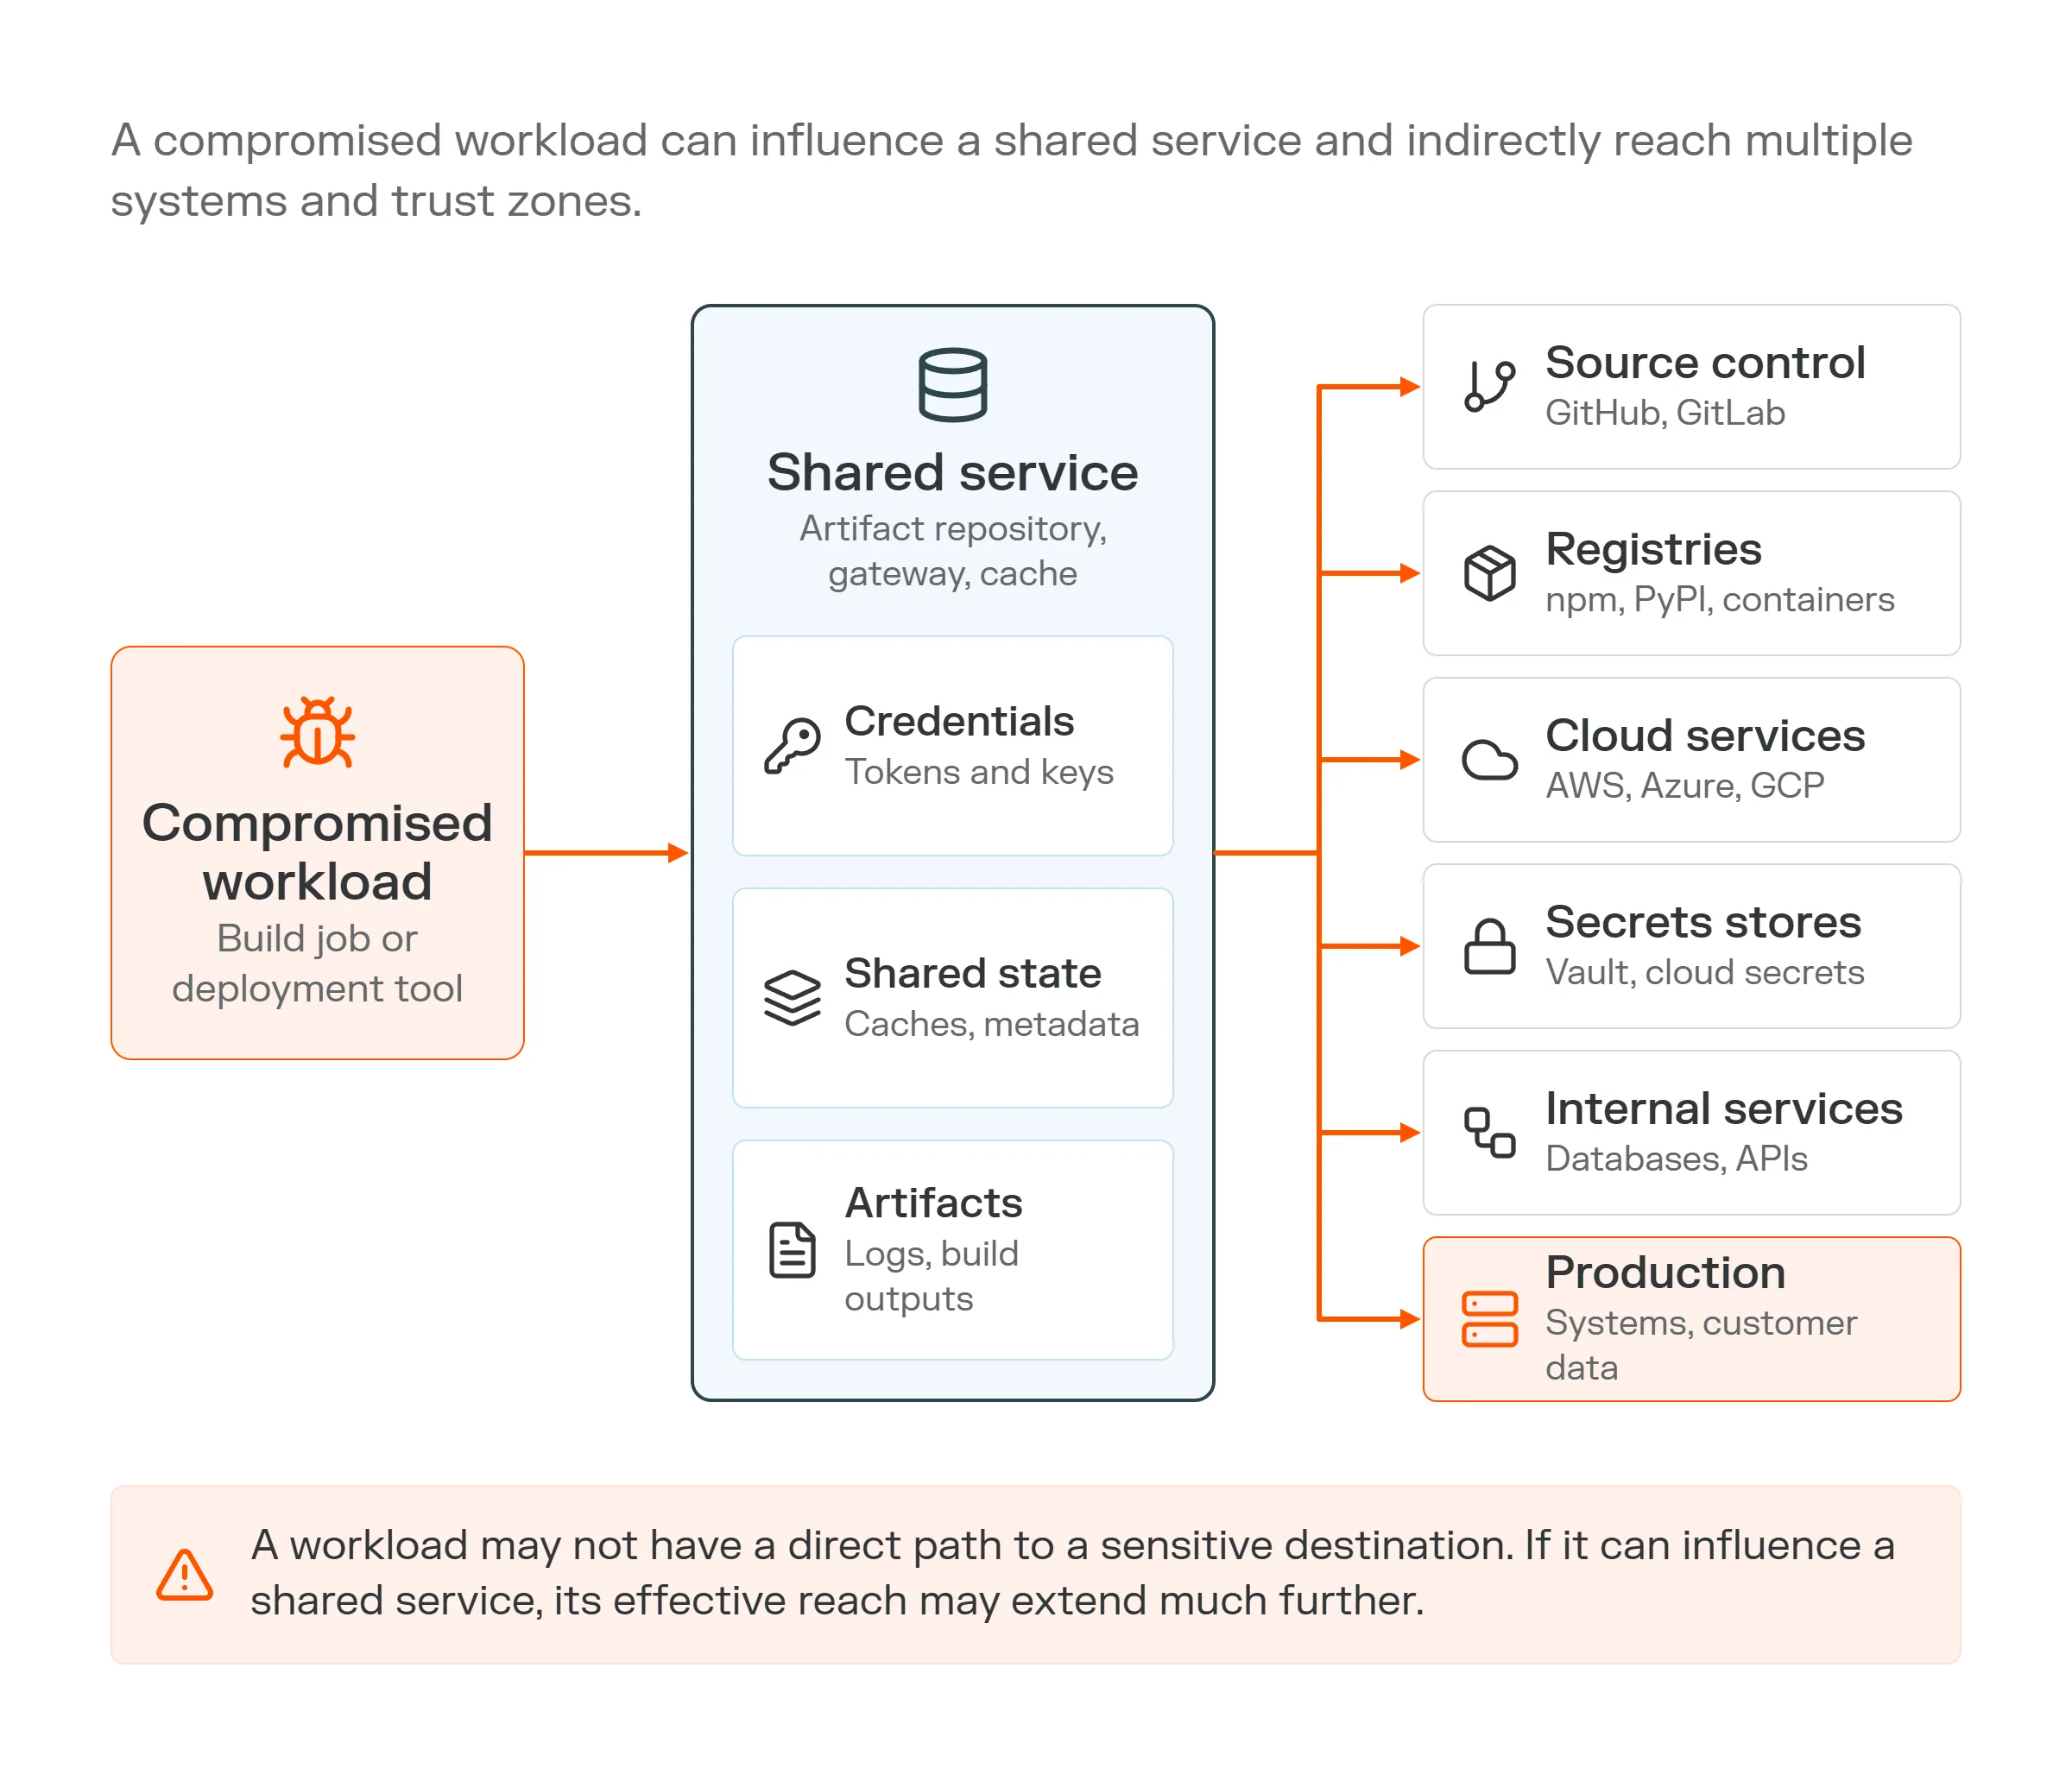
. Uma carga de trabalho capaz de direcionar um serviço compartilhado pode alcançar tudo o que esse serviço consegue alcançar, desde credenciais até produção.
Uma visão de alcance faz três perguntas adicionais:
- O que uma carga de trabalho pode fazer com que este serviço faça?
- O que o serviço pode alcançar em seu nome?
- O que o serviço retém de outras cargas de trabalho?
Um proxy de artefatos pode se conectar a registros externos. Um serviço de compilação pode obter o código-fonte, assinar um artefato e publicá-lo. Um gateway pode se conectar a APIs internas, serviços em nuvem ou bancos de dados. Uma carga de trabalho pode, portanto, não ter nenhuma ligação direta com um sistema sensível, mas ainda assim ser capaz de influenciar um serviço que a tenha.
A questão do estado compartilhado também é importante. Um cache gravado por um fluxo de trabalho pode ser posteriormente consumido por outro, os registros podem reter credenciais e artefatos ou metadados podem ser transferidos entre ambientes que, de outra forma, pareceriam separados. O ataque TanStack funcionava desta maneira. O código de uma solicitação pull externa corrompeu um cache de compilação compartilhado, e o fluxo de trabalho de lançamento do projeto o restaurou horas depois.
Quando uma carga de trabalho pode influenciar um serviço compartilhado, seu alcance pode se estender aos sistemas, credenciais e estado subjacentes a esse serviço.
A prevenção não informa o raio da explosão.
As equipes já possuem um conjunto robusto de ferramentas para reduzir os riscos na cadeia de suprimentos de software. Essas funcionalidades incluem verificação de dependências, listas de materiais de software (SBOMs), ramificações protegidas, assinatura de artefatos, atestados de compilação, detecção de malware, publicação confiável e identidades de curta duração. Essas ferramentas ainda são essenciais, mas a maioria delas foi criada para impedir ataques ou para comprovar que o código é confiável.
Eles não respondem completamente o que acontece quando essa confiança é quebrada. A identidade de um desenvolvedor pode ser roubada, um fluxo de trabalho confiável pode ser modificado, um processo de compilação legítimo pode produzir algo malicioso ou um estado compartilhado pode migrar de um ambiente de baixa confiança para um de alta confiança.
É aí que a prevenção e a contenção respondem a perguntas diferentes. A prevenção questiona se podemos impedir que softwares maliciosos entrem. A contenção questiona até que ponto o acordo pode chegar se a prevenção falhar.
Ambos pertencem à segurança da cadeia de suprimentos de software, pois o ponto de apoio inicial é apenas uma parte do resultado final.
Como limitar o alcance de um comprometimento na cadeia de suprimentos
O controle da cadeia de suprimentos não depende de um único fator de controle perfeito. O objetivo é reduzir o número de próximos passos úteis disponíveis para um atacante após algo dar errado, e essas quatro práticas são um bom ponto de partida.
Limitar o valor das credenciais
Utilize identidades com escopo restrito e separe os privilégios de compilação, publicação e implantação sempre que possível. Credenciais de curta duração ajudam, mas o escopo é igualmente importante, pois uma credencial que existe por apenas alguns minutos ainda pode causar danos significativos se tiver permissões amplas.
Separe diferentes níveis de confiança.
Fluxos de trabalho de desenvolvimento, builds de pull requests não confiáveis, sistemas de release e produção não devem compartilhar automaticamente estado gravável, credenciais ou privilégios. Quando for necessário compartilhar infraestrutura, separe as permissões e as políticas de acesso sempre que possível.
Reduzir conectividade desnecessária
Os sistemas de compilação geralmente têm amplo acesso à rede porque isso facilita a engenharia, mas códigos maliciosos também recebem esse mesmo acesso. Se uma carga de trabalho precisar apenas de um pequeno número de destinos, esses devem ser os caminhos que ela receberá.
O mesmo princípio se aplica aos serviços compartilhados. Um proxy de artefatos pode precisar de acesso a alguns registros, enquanto um gateway interno pode precisar de um conjunto definido de APIs. Nenhum dos dois precisa de conectividade irrestrita simplesmente por estar localizado dentro da rede.
É aqui que a segmentação se torna particularmente valiosa. Cada caminho desnecessário removido representa um caminho a menos que um atacante pode usar após obter o acesso inicial.
Trate a infraestrutura do desenvolvedor como infraestrutura sensível.
Sistemas de CI, repositórios de artefatos, portais de desenvolvedores, gateways de IA e serviços de compilação podem conter credenciais ou conectividade tão valiosas quanto os sistemas em produção. Proteja-os com base no que eles podem alcançar e no que eles retêm, sejam eles considerados internos ou não.
Comece com o raio da explosão.
Uma maneira simples de aplicar esse raciocínio é escolher uma estação de trabalho de desenvolvedor, um executor de CI, um serviço de compilação, um gateway ou um repositório de artefatos e presumir que ele já foi comprometido.
Em seguida, afaste-se e observe o que se revela em seguida:
- Credenciais. Quais tokens, chaves ou identidades estão disponíveis?
- Acesso. A que essas identidades podem ser autenticadas?
- Conectividade. Com quais sistemas este ambiente pode se comunicar?
- Serviços compartilhados. Quais intermediários ela pode influenciar e o que eles podem alcançar ou reter?
- Próximo passo. Existe algum outro sistema que exponha uma credencial, identidade ou caminho adicional?
Isso transforma o exercício, que deixa de ser simplesmente encontrar um componente vulnerável e passa a ser compreender um caminho de ataque. As descobertas podem parecer pequenas individualmente, como uma função de nuvem com privilégios excessivos, um token de publicação que deveria ter expirado, um cache compartilhado, um caminho de rede desnecessário ou um registro que retém credenciais.
Em conjunto, esses detalhes determinam se o compromisso se limita a uma carga de trabalho ou se estende muito mais.
Para onde a violação de dados pode se estender em seguida?
Continuaremos dependendo de softwares que não desenvolvemos, portanto, a aplicação de patches, a rastreabilidade, os processos de compilação seguros e a publicação confiável continuarão sendo importantes. Planos de contenção para o caso de um deles falhar.
Uma vez que um código malicioso esteja sendo executado dentro de algo confiável, a questão mais importante passa a ser para onde ele pode se espalhar em seguida.
Isso significa analisar as identidades em torno da carga de trabalho, os sistemas que ela pode alcançar e os serviços compartilhados que conectam diferentes partes do ambiente. Pode ser difícil impedir o primeiro ponto de apoio todas as vezes, mas o próximo não precisa ser automático.
O atacante do LiteLLM precisou de uma cadeia de etapas para chegar ao PyPI: uma chave vazada, uma plataforma interna, o token do proprietário, uma rodada de segredos de CI roubados e, finalmente, o fluxo de trabalho de lançamento. Cada link representava mais uma oportunidade para impedir a propagação.
Um componente comprometido deve permanecer um componente comprometido.
Veja como o Illumio ajuda você a mapear o alcance de cada carga de trabalho e a bloquear os caminhos que um invasor poderia usar após o primeiro ponto de acesso. Agende uma demonstração hoje mesmo.