La cadena de suministro de software es ahora un problema de movimiento lateral
El 21 de octubre, los atacantes lanzaron una versión maliciosa de LiteLLM, una popular biblioteca de Python con aproximadamente 23 millones de descargas semanales. Se envió a través de la propia cadena de lanzamiento del proyecto a PyPI y sus imágenes oficiales de Docker.
Cualquiera que revisara la etiqueta oficial de código fuente en GitHub no encontró nada malo, porque los archivos maliciosos nunca la tocaron.
La liberación envenenada fue el último salto del ataque. El análisis de causa raíz de LiteLLM lo rastrea hasta una clave de administrador que se comprometió accidentalmente en un repositorio público en mayo. Esa clave abría una plataforma interna de agentes, que contenía un token de GitHub perteneciente al propietario de una organización. A partir de ahí, el atacante empleó flujos de trabajo de CI para extraer más tokens. Luego dirigieron la pipeline de liberación a un repositorio similar.
Es el último de un serial de incidentes similares este año. En mayo, un grupo de investigadores identificados como TeamPCP abusó de la cadena CI/CD de TanStack para publicar 84 versiones maliciosas de paquetes bajo la identidad npm de confianza del proyecto. En agosto, la campaña ChainDrop empleó credenciales robadas para extender por cientos de paquetes npm, muchos de ellos con procedencia válida.
En cada caso, el software de confianza se convirtió en una vía de ataque mientras que los controles a su alrededor parecían funcionar. Una vez que el código malicioso se instala en un entorno de confianza, ¿a dónde puede ir después? Un ejecutor de compilación puede tener credenciales en la nube o licencias de publicación, y un servicio interno puede conectarse a sistemas a los que sus llamantes no pueden acceder directamente.
Por eso la seguridad de la cadena de suministro de software debe tratar ahora tanto como un problema de movimiento lateral como como un problema de dependencia.
El paquete es solo el primer salto
Cuando un componente de terceros se convierte en un problema de seguridad, los equipos naturalmente comienzan con el propio componente:
- ¿Es vulnerable?
- ¿Fue modificada?
- ¿Dónde se va a correr?
- ¿Existe una versión segura?
Esas preguntas importan, pero solo describen el punto de entrada. Un paquete comprometido que se ejecuta dentro de una máquina o entorno de compilación de un desarrollador puede encontrar de repente junto a credenciales de control de versiones, publicando tokens, identidades en la nube, acceso a Kubernetes, APIs internas y rutas de red hacia otros sistemas.
En ese momento, el paquete ya cumplió la parte importante al obtener la ejecución dentro de algo de confianza. El entorno determina lo que ocurre a continuación.
Los equipos suelen imaginar la ruta de ataque como una línea recta desde un paquete malicioso hasta una aplicación comprometida. Es más útil rastrear la ruta completa: el paquete malicioso aterriza en un entorno de confianza, recoge las credenciales y accesos disponibles allí, y los emplea para acceder a sistemas adicionales.
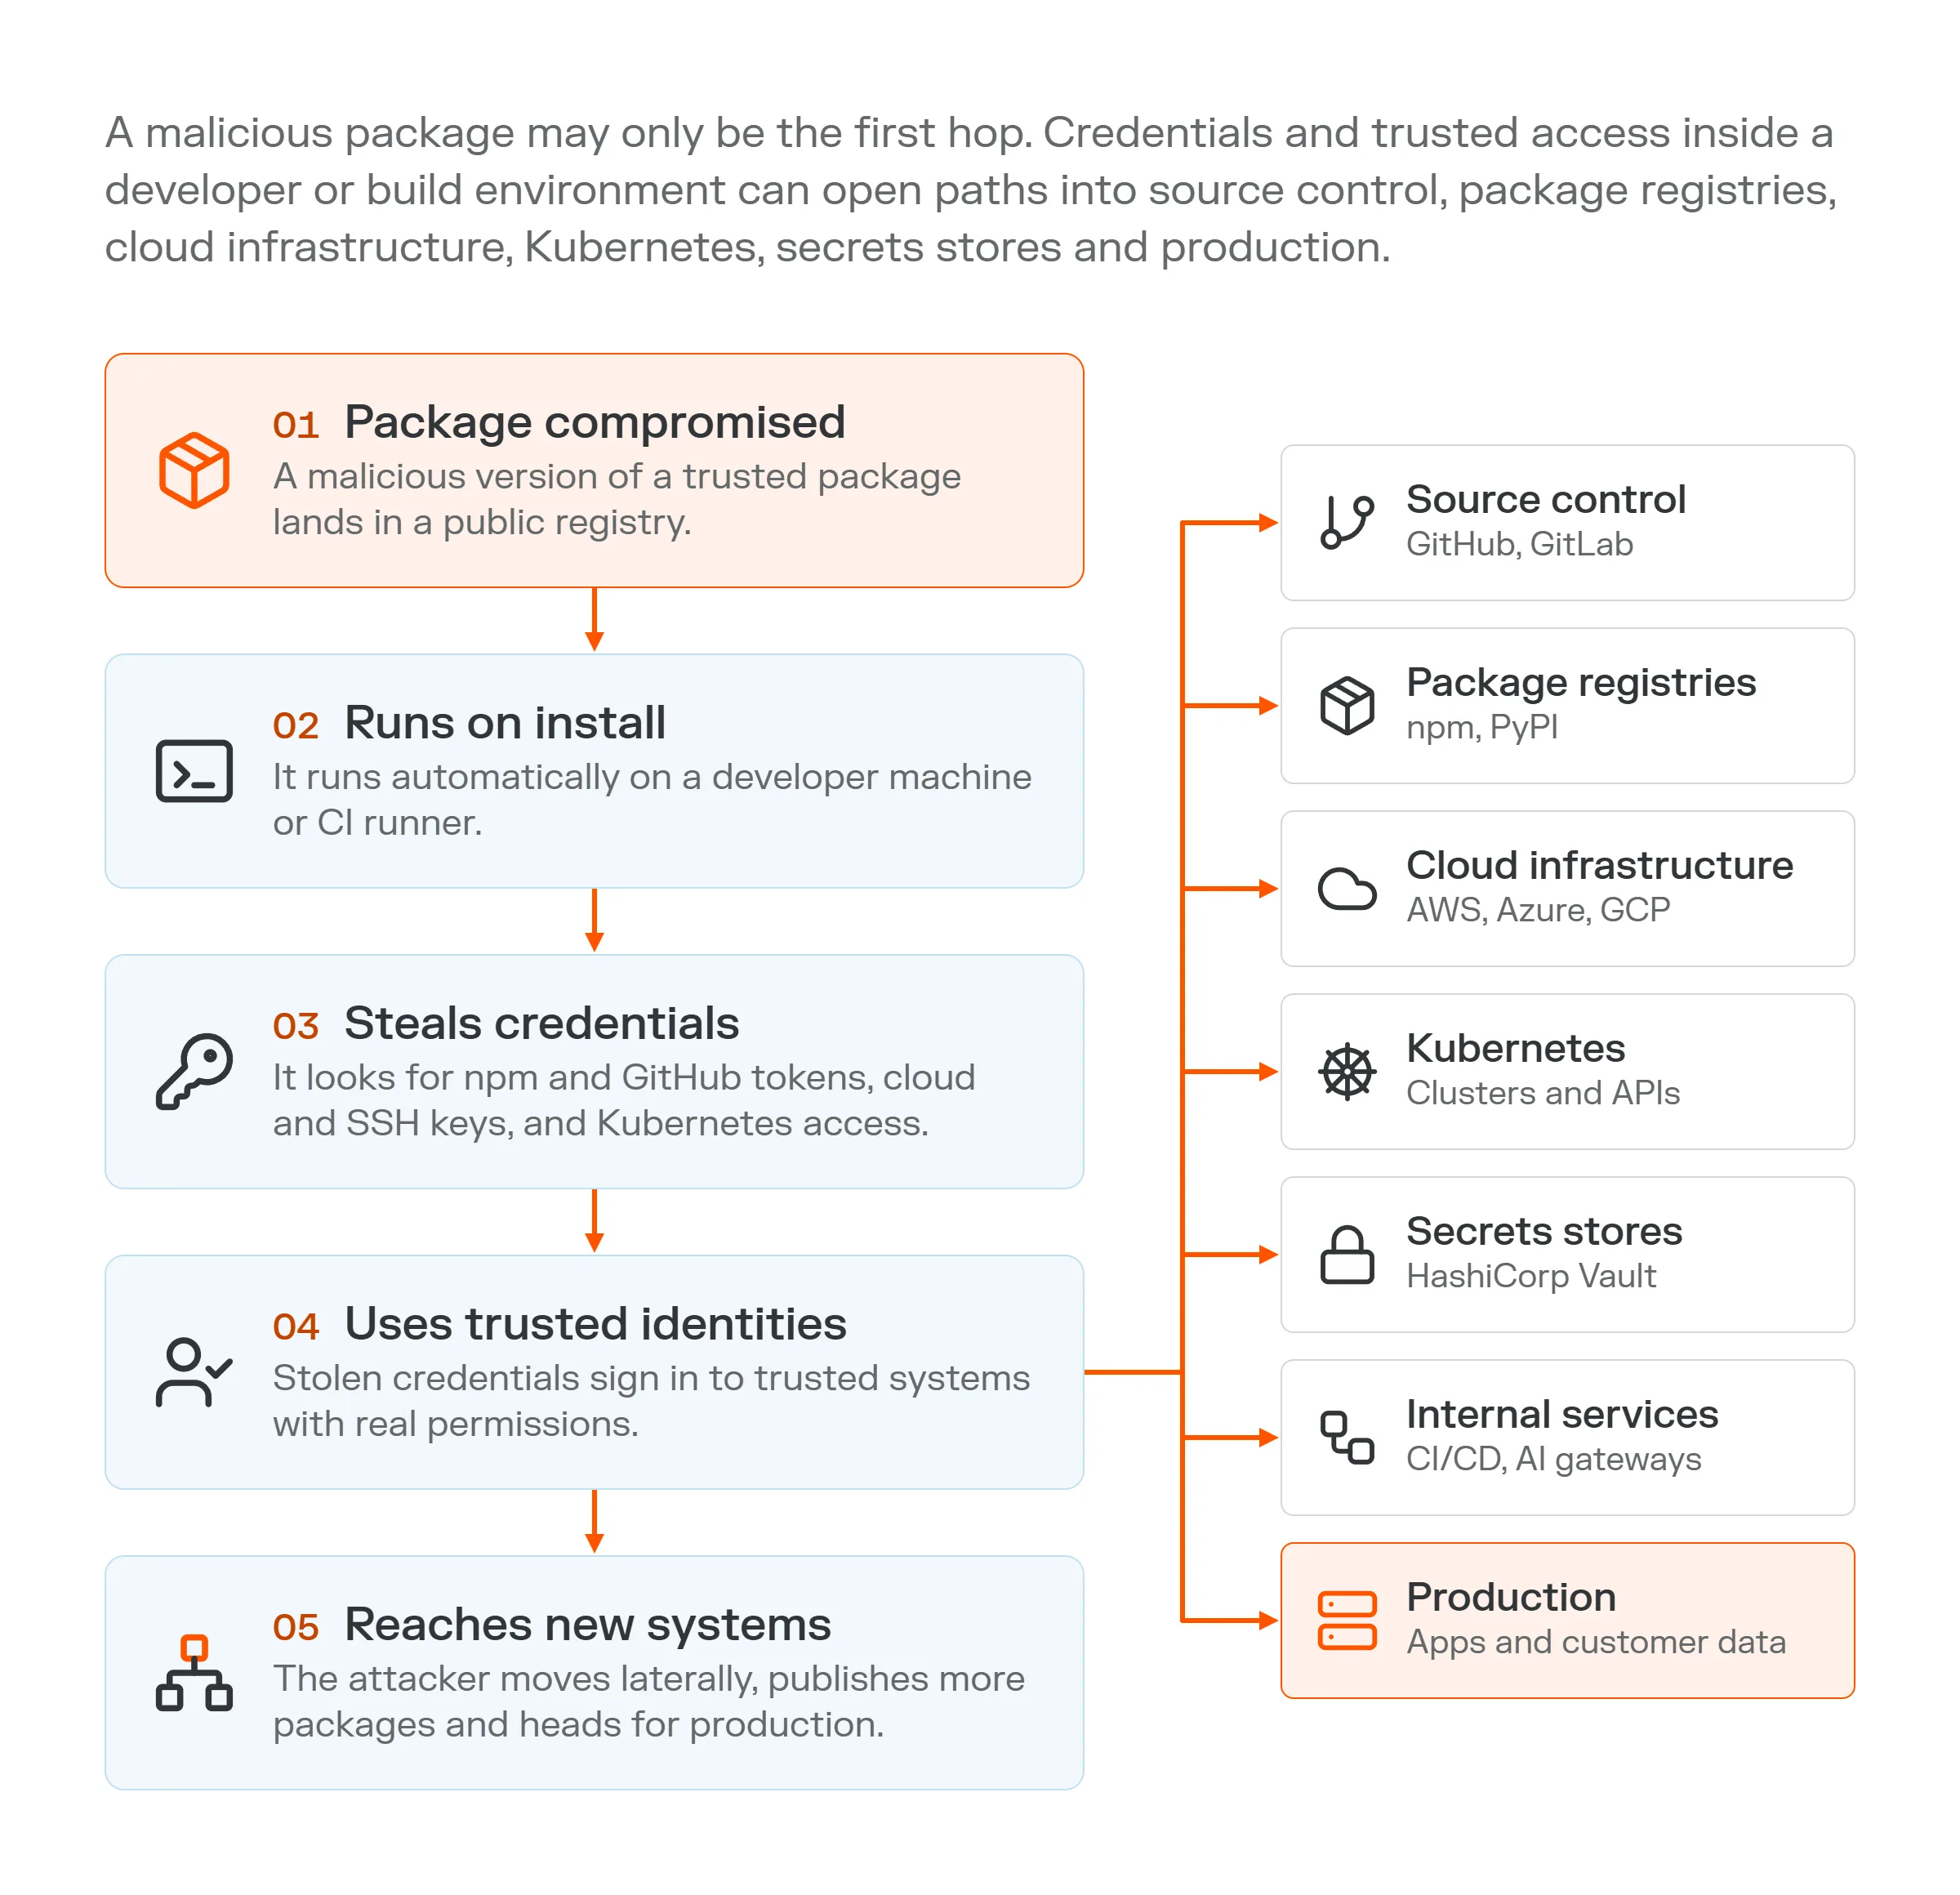
Un paquete malicioso puede ser solo el primer salto. Credenciales y acceso confiable dentro de un entorno de desarrollador o compilación
puede crear rutas hacia control de versiones, registros de paquetes, infraestructura en la nube, Kubernetes, almacenes de secretos y producción.
Dos compañías pueden ejecutar el mismo paquete comprometido y experimentar resultados muy diferentes. En un entorno, el código malicioso puede no tener ningún lugar útil al que ir. En otro, puede estar funcionando junto a credenciales poderosas y una amplia conectividad interna.
El paquete proporciona el punto de apoyo. El entorno determina el radio de la explosión.
El riesgo de esconder en medio
Las discusiones sobre seguridad suelen centrar en los dos extremos de la cadena de suministro de software: el componente de terceros que podría ver comprometido y el sistema de producción que queremos proteger. Pero hay mucho entre ellos.
Repositorios de artefactos, proxies de paquetes, cachés de CI, plataformas de compilación, herramientas internas para desarrolladores, gateways de IA, servicios secretos y otras infraestructuras compartidas conectan diferentes partes de los entornos de desarrollo y producción. Los equipos suelen tratar estos sistemas como fontanería de infraestructura, pero también como límites de seguridad.
Un servicio compartido puede ser accesible desde muchos entornos. Puede almacenar credenciales, almacenar datos que otras cargas de trabajo usan más adelante o conectarse a sistemas a los que sus llamantes no pueden acceder directamente. Una forma útil de pensar en estos sistemas es como intermediarios. Realizan trabajo en nombre de otras cargas de trabajo, lo que puede extender el alcance del llamante más allá del propio broker.
La plataforma de agentes internos de LiteLLM es un claro ejemplo. Existía para abrir pull requests, así que tenía un token de GitHub. Ese token pertenecía al propietario de una organización, por lo que quien controlaba la plataforma obtenía alcance a nivel de propietario en los repositorios de la compañía.
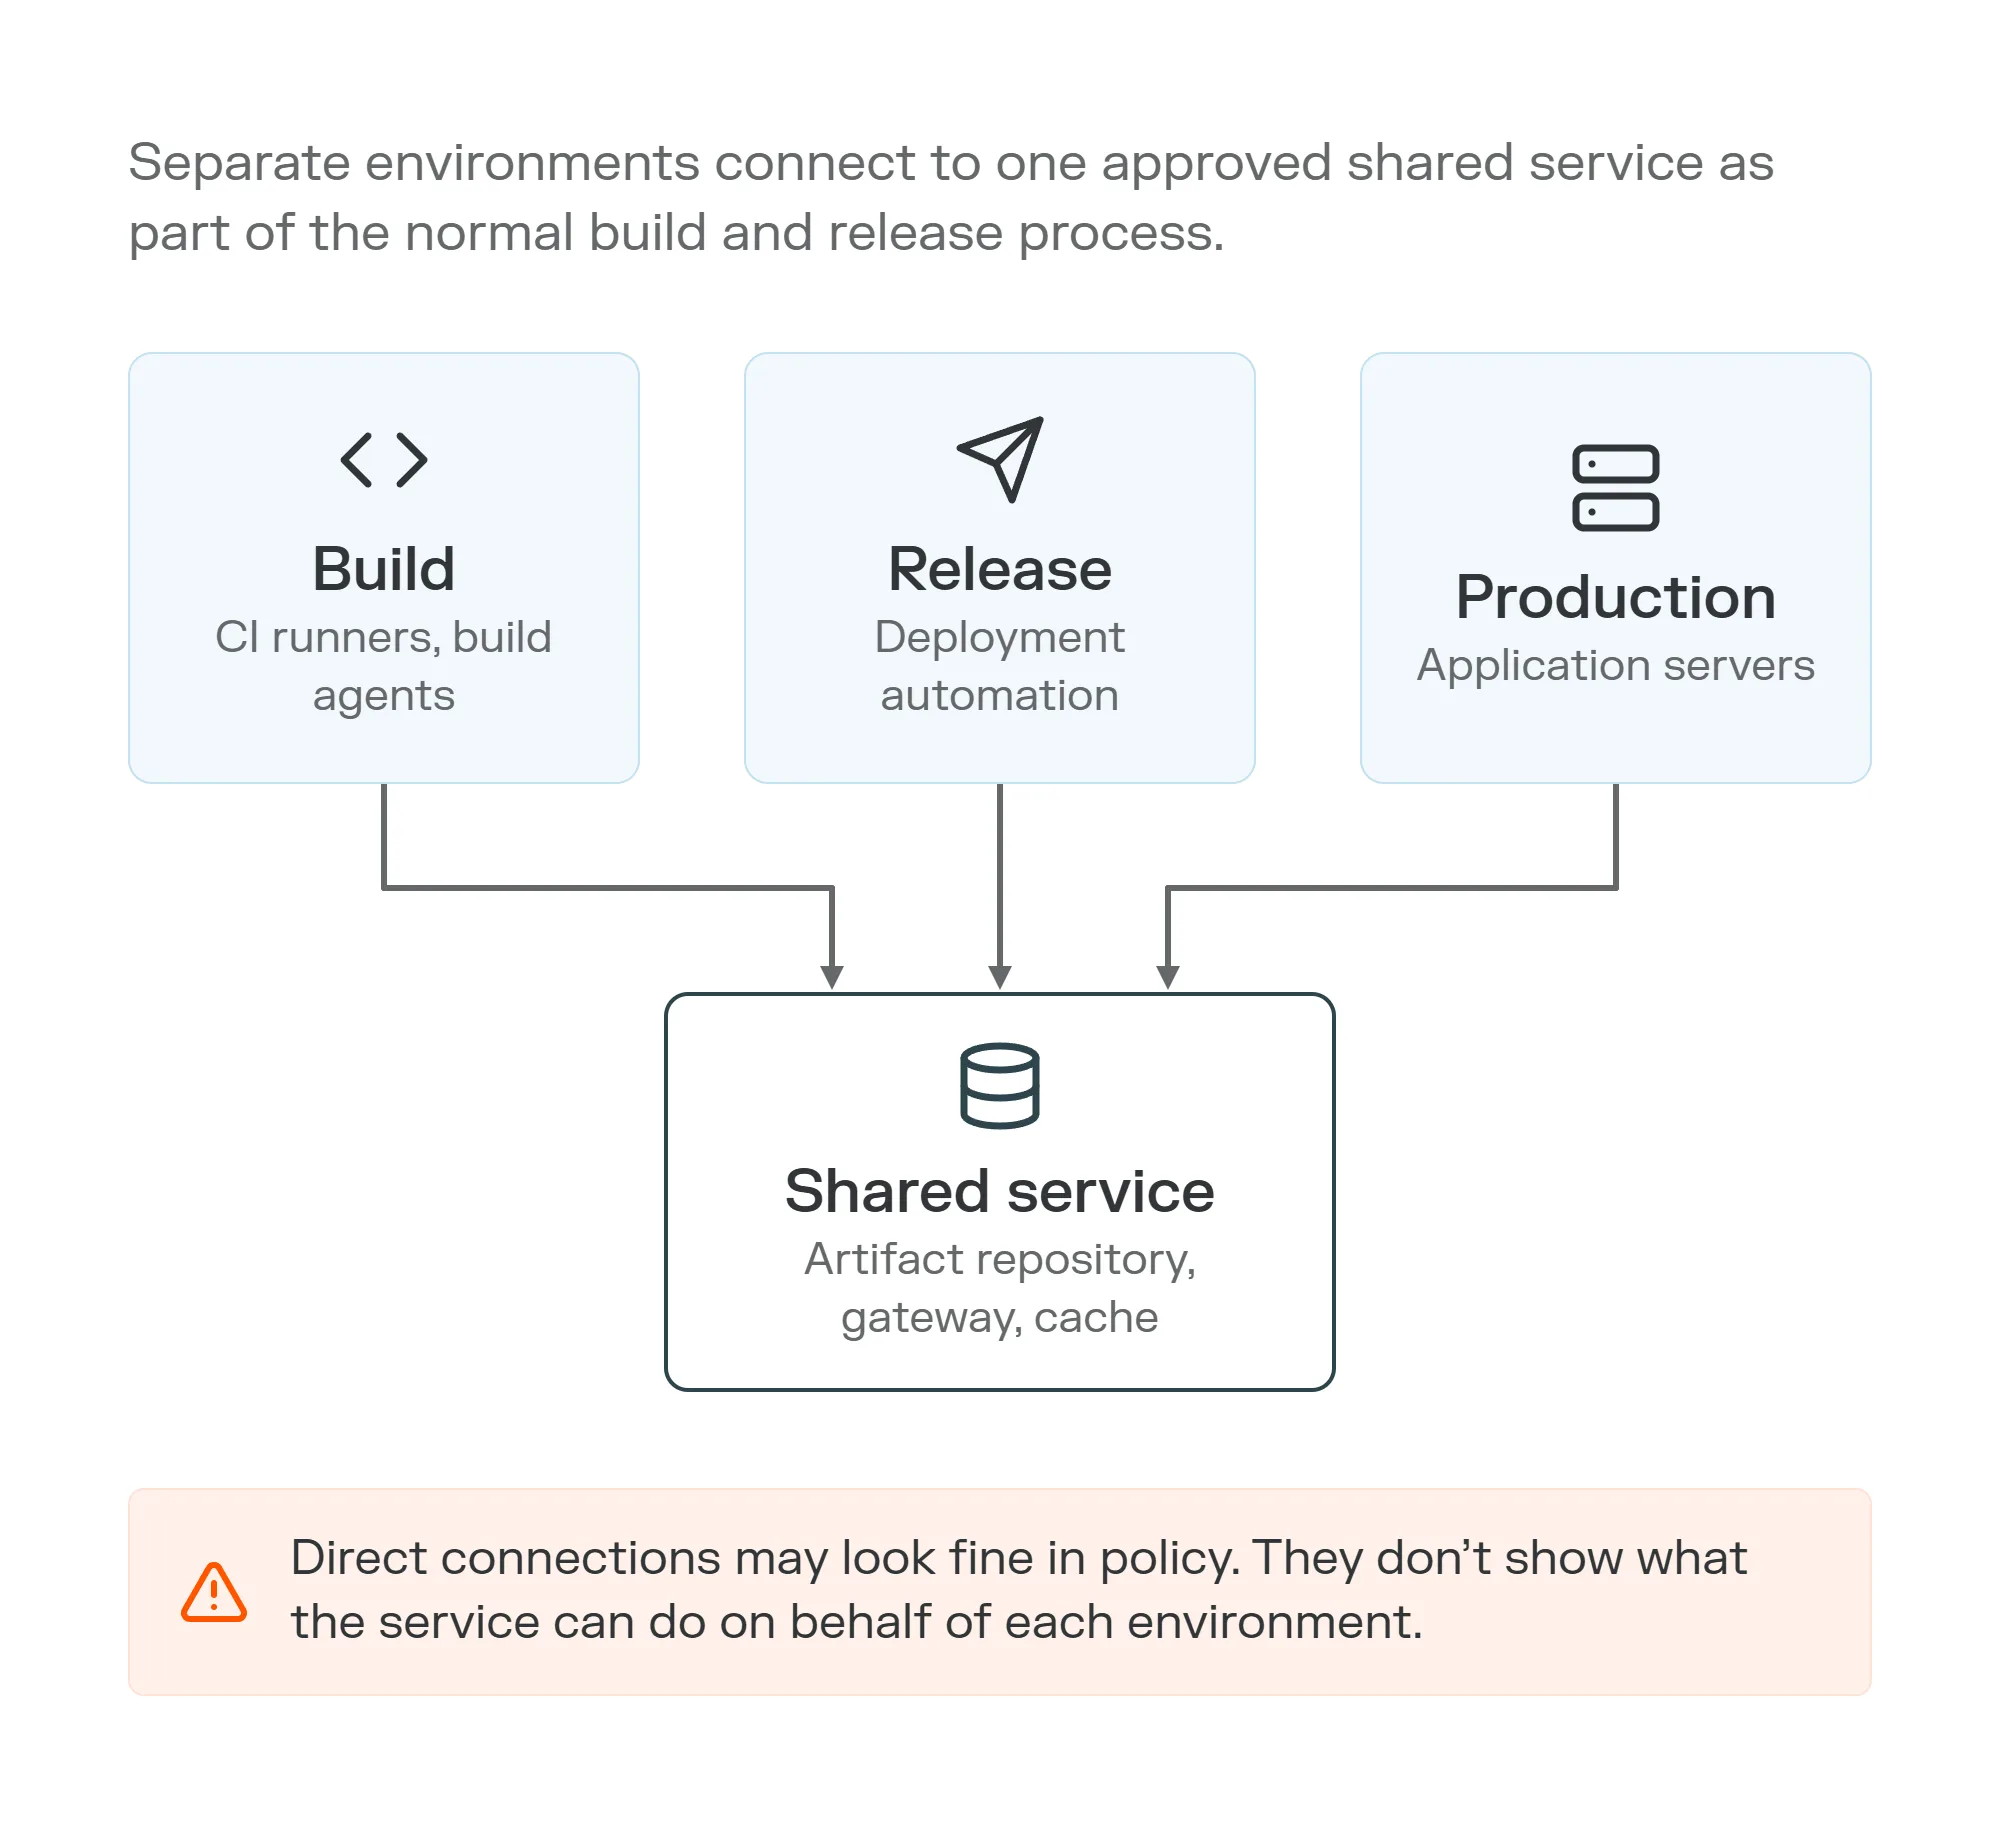
Proceso de construcción y lanzamiento. Construcción, lanzamiento y producción tienen cada uno un enlace aprobado a un servicio compartido. Sobre el papel, parecen bien separados.
Desde una perspectiva de política, nada parece inusual: un entorno de compilación se conecta a un repositorio de artefactos, un flujo de trabajo de lanzamiento se conecta al mismo repositorio y producción recupera artefactos de él. Cada conexión puede ser esperada y aprobada.
El problema es que la conectividad directa no muestra la relación de confianza completa. No nos dice qué puede hacer el servicio compartido, qué estado mantiene ni dónde puede comunicar a continuación.
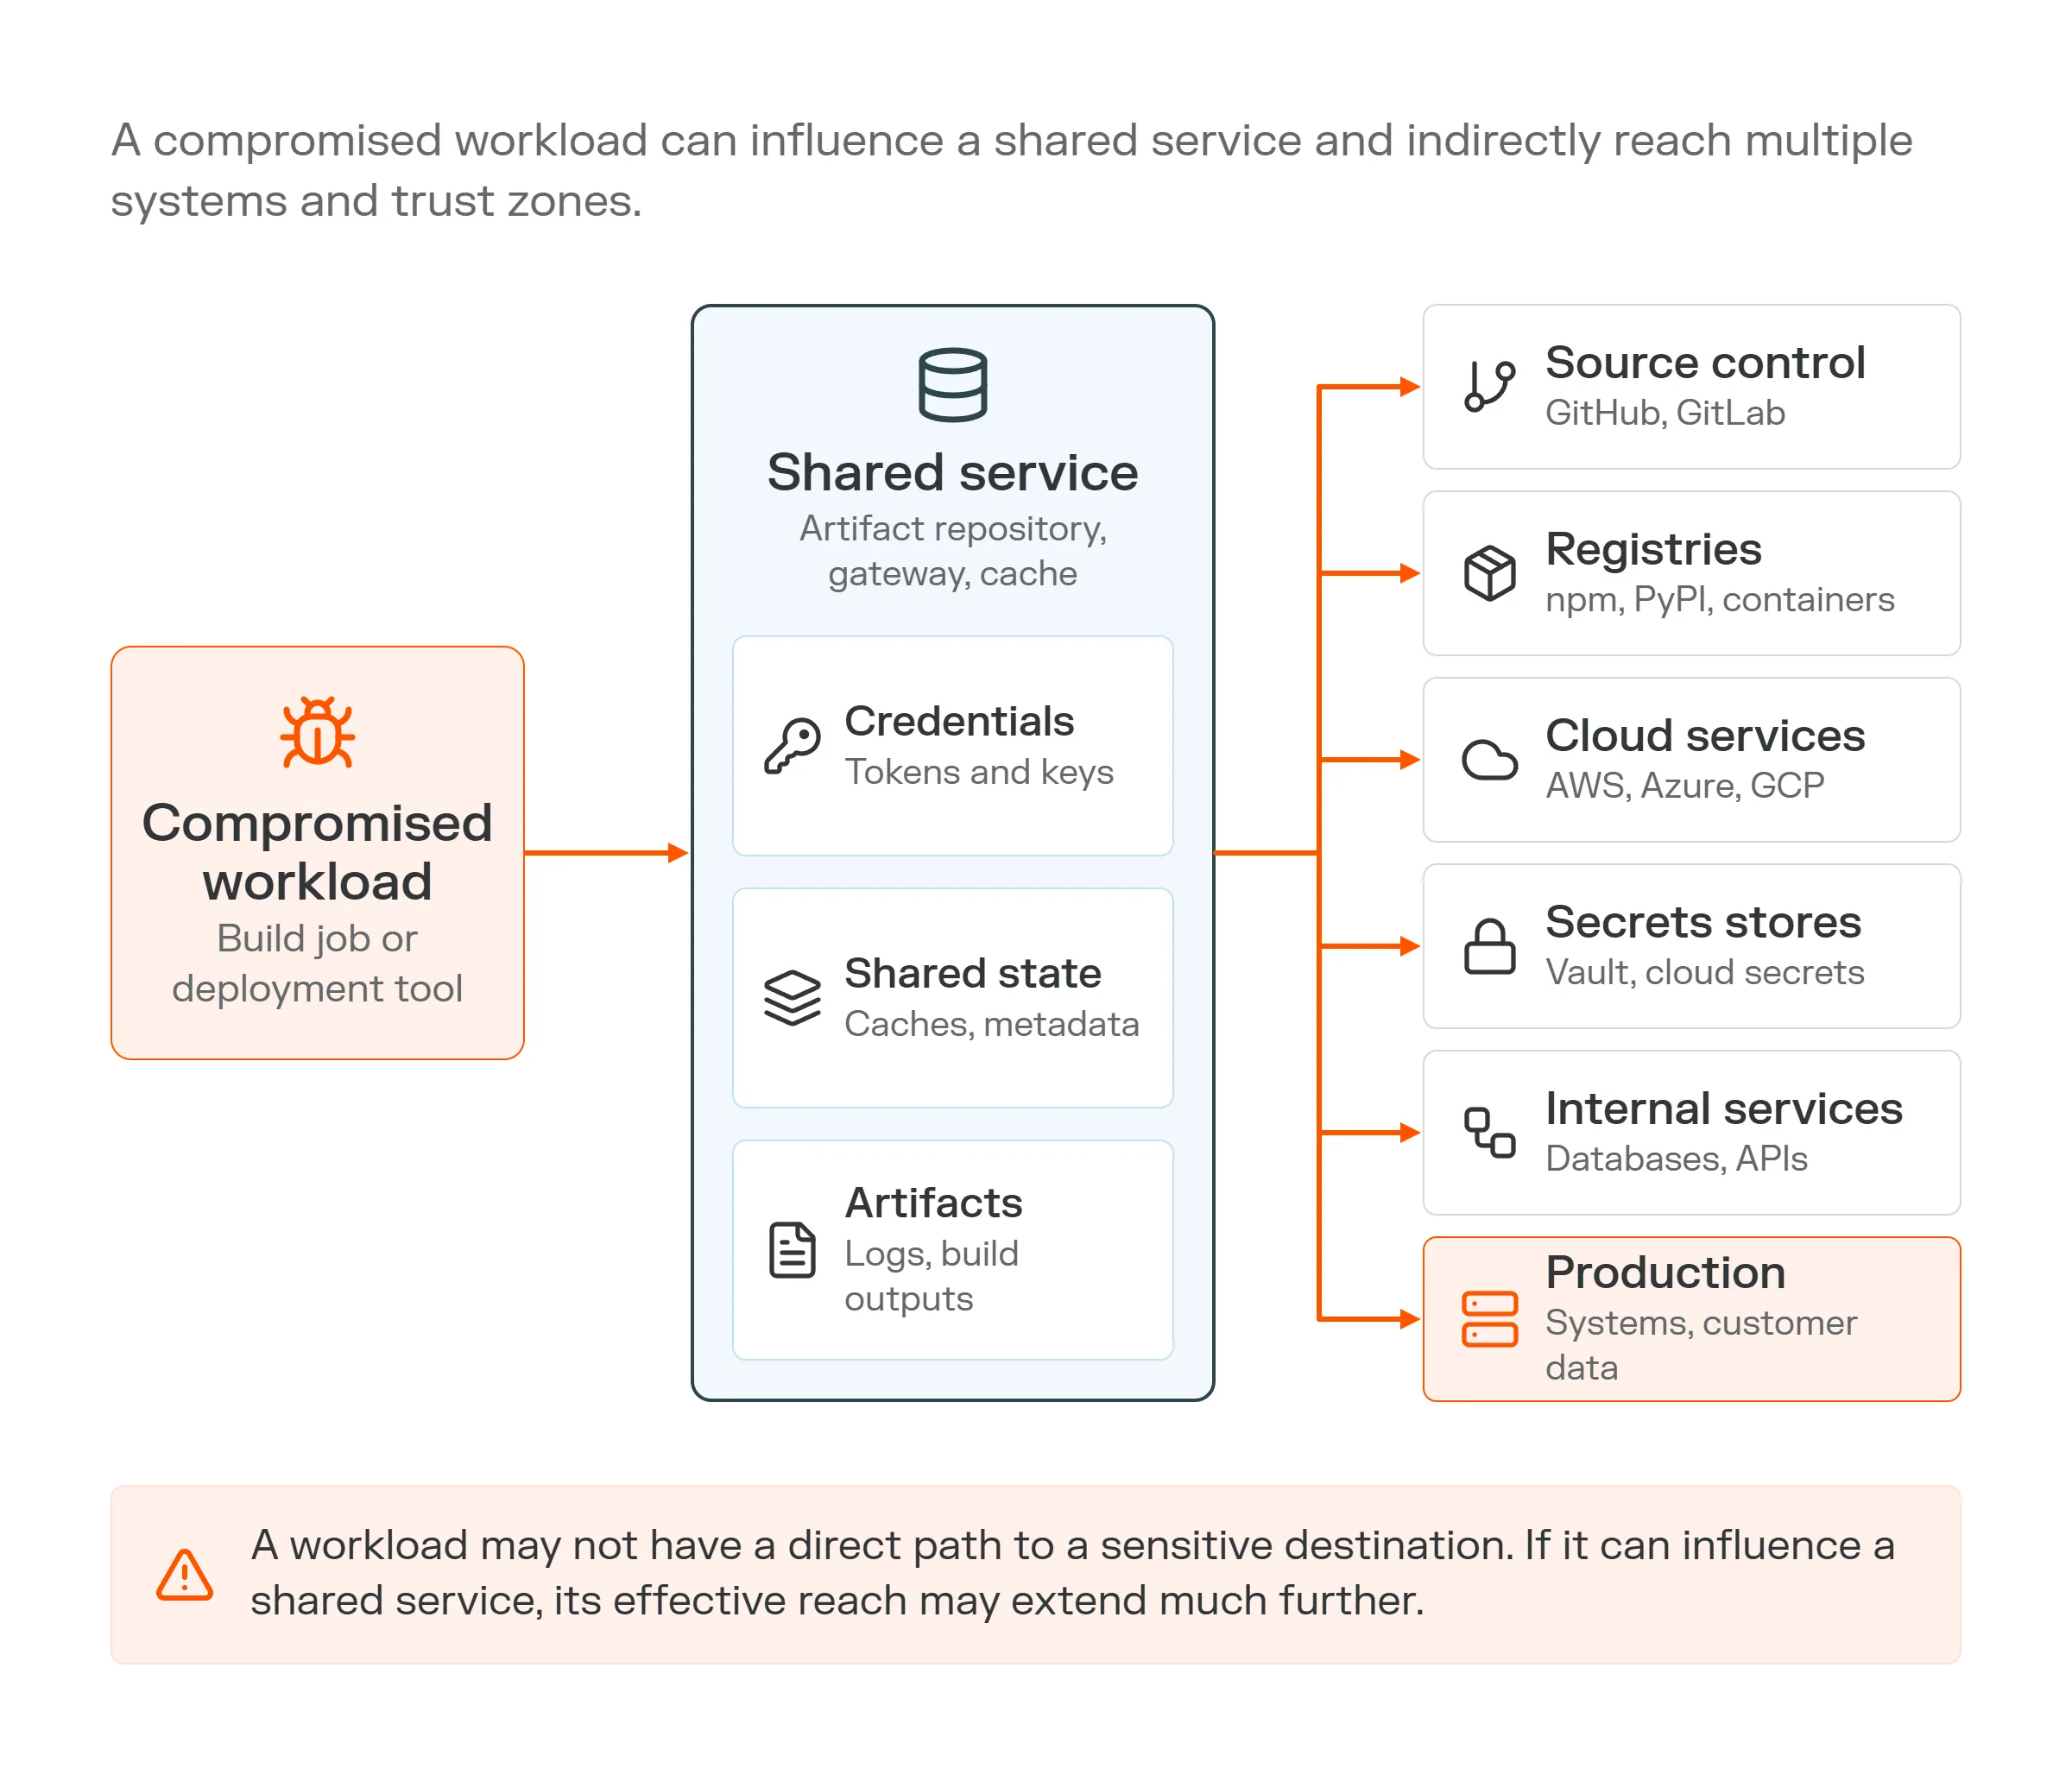
Zonas de confianza. Una carga de trabajo que puede dirigir un servicio compartido puede alcanzar cualquier cosa que ese servicio pueda alcanzar, desde credenciales hasta producción.
Una vista de alcance plantea tres preguntas adicionales:
- ¿Qué puede hacer una carga de trabajo con este servicio?
- ¿Qué puede llegar el servicio en su nombre?
- ¿Qué retiene el servicio de otras cargas de trabajo?
Un proxy de artefacto puede conectarse a registros externos. Un servicio de compilación puede obtener el código-fuente, firmar un artefacto y publicarlo. Una pasarela puede conectarse a APIs internas, servicios en la nube o bases de datos. Por tanto, una carga de trabajo puede no tener conexión directa con un sistema sensible y aun así influir en un servicio que sí la tiene.
El estado compartido también importa. Una caché escrita por un flujo de trabajo puede ser consumida posteriormente por otro, los registros pueden conservar credenciales y artefactos o metadatos pueden mover entre entornos que de otro modo parecen estar separados. El ataque TanStack funcionó así. El código de una solicitud pull externa envenenó una caché de compilación compartida, y el flujo de trabajo de liberación del proyecto la restauró horas después.
Cuando una carga de trabajo puede influir en un servicio compartido, su alcance puede extender a los sistemas, credenciales y estado detrás de ese servicio.
La prevención no te dice el radio de la explosión
Los equipos ya cuentan con un conjunto estable de herramientas para reducir el riesgo en la cadena de suministro de software. Incluyen escaneo de dependencias, listas de materiales de software (SBOMs), sucursales protegidas, firma de artefactos, atestiguaciones de compilación, detección de malware, publicaciones confiables e identidades de corta duración. Estas herramientas siguen siendo esenciales, pero la mayoría están diseñadas para mantener fuera a los atacantes o para demostrar que el código es de fiar.
No responden completamente a lo que ocurre cuando esa confianza falla. Se puede robar la identidad de un desarrollador, modificar un flujo de trabajo de confianza, un proceso de compilación legítimo puede producir algo malicioso, o el estado compartido puede pasar de un entorno de baja confianza a uno de mayor confianza.
Ahí es donde la prevención y la contención responden a diferentes preguntas. Prevención pregunta si podemos evitar que el software malicioso llegue. La contención pregunta hasta dónde puede llegar el compromiso si la prevención falla.
Ambos pertenecen a la seguridad de la cadena de suministro de software porque la base inicial es solo una parte del resultado final.
Cómo limitar lo que puede alcanzar un compromiso en la cadena de suministro
La contención de la cadena de suministro no depende de un control perfecto. El objetivo es reducir el número de siguientes pasos útiles disponibles para un atacante después de que algo salga mal, y estas cuatro prácticas son un buen punto de partida.
Limitar el valor de las credenciales
Emplea identidades con un alcance limitado y privilegios separados de construcción, publicación y despliegue siempre que sea posible. Las credenciales de corta duración ayudan, pero el alcance importa igual porque una credencial que solo existe unos minutos puede causar daños significativos si tiene licencias amplias.
Separar los diferentes niveles de confianza
Los flujos de trabajo de desarrollo, compilaciones de pull request no confiables, sistemas de lanzamiento y producción no deberían compartir automáticamente estados, credenciales o privilegios que se puedan escribir. Cuando sea necesaria la infraestructura compartida, separar licencias y políticas de acceso tanto como sea posible.
Reducir la conectividad innecesaria
Los sistemas de compilación suelen tener acceso amplio a la red porque facilita la ingeniería, pero el código malicioso recibe ese mismo acceso. Si una carga de trabajo solo necesita un pequeño número de destinos, esos deberían ser los caminos que obtiene.
El mismo principio se aplica a los servicios compartidos. Un proxy de artefacto puede necesitar acceso a varios registros, mientras que una pasarela interna puede necesitar un conjunto definido de APIs. Ninguno de los dos necesita conectividad sin restricciones simplemente porque está dentro de la red.
Aquí es donde la segmentación se vuelve especialmente valiosa. Cada ruta innecesaria eliminada es una ruta menos que un atacante puede usar tras la primera posición de apoyo.
Trata la infraestructura de los desarrolladores como una infraestructura sensible
Los sistemas de CI, repositorios de artefactos, portales para desarrolladores, gateways de IA y servicios de compilación pueden poseer credenciales o conectividad tan valiosas como los sistemas en producción. Protégelos según lo que puedan alcanzar y lo que retengan, se consideren internos o no.
Empieza por el radio de la explosión
Una forma sencilla de aplicar este pensamiento es elegir una estación de trabajo de desarrollador, un runner de CI, un servicio de construcción, un gateway o un repositorio de artefactos y asumir que ya fue comprometido.
Luego ve hacia afuera y mira qué será lo que estará disponible a continuación:
- Credenciales. ¿Qué tokens, claves o identidades están disponibles?
- Acceso. ¿A qué pueden autenticar esas identidades?
- Conectividad. ¿Con qué sistemas puede comunicar este entorno?
- Servicios compartidos. ¿Qué intermediarios puede influir y qué pueden alcanzar o retener?
- Siguiente salto. ¿Otro sistema revela una credencial, identidad o camino adicional?
Esto cambia el ejercicio de simplemente encontrar un componente vulnerable a entender una ruta de ataque. Los hallazgos pueden parecer pequeños individualmente, como un rol en la nube demasiado privilegiado, un token de publicación que debería caducar, una caché compartida, una ruta de red innecesaria o un registro que conserve las credenciales.
En conjunto, esos detalles deciden si el compromiso se queda en una carga de trabajo o se extiende mucho más lejos.
¿A dónde puede ir el incumplimiento a continuación?
Seguiremos dependiendo de software que no escribimos, así que el parcheo, la procedencia, los pipelines de compilación seguros y la publicación confiable seguirán siendo importantes. Planes de contención para el momento en que uno de ellos falle.
Una vez que hay código malicioso ejecutar dentro de algo confiable, la pregunta más importante es hacia dónde puede ir a continuación.
Eso significa fijar en las identidades alrededor de la carga de trabajo, los sistemas a los que puede llegar y los servicios compartidos que conectan diferentes partes del entorno. El primer apoyo puede ser difícil de evitar siempre, pero el siguiente no tiene por qué ser automático.
El atacante de LiteLLM necesitaba una cadena de saltos para llegar a PyPI: una clave filtrada, una plataforma interna, un token del propietario, una ronda de secretos de CI robados y, finalmente, el flujo de trabajo de liberación. Cada vínculo era otra oportunidad para frenar la propagación.
Un componente comprometido debe seguir siendo un componente comprometido.
Mira cómo Illumio te ayuda a mapear hasta dónde puede llegar cada carga de trabajo y cerrar los caminos que un atacante podría usar tras el primer punto de apoyo. Reserva una demo hoy mismo.