La chaîne d’approvisionnement logicielle est désormais un problème de mouvement latéral
Le 21 octobre, des attaquants ont publié une version malveillante de LiteLLM, une bibliothèque Python populaire avec environ 23 millions de téléchargements hebdomadaires. Il a été diffusé via le pipeline de libération du projet vers PyPI et ses images officielles Docker.
Quiconque aurait vérifié le tag source officiel sur GitHub n’aurait rien trouvé d’anormal, car les fichiers malveillants ne l’ont jamais touché.
La libération empoisonnée fut le dernier bond de l’attaque. L’analyse de la cause profonde de LiteLLM remonte à une clé d’administration accidentellement engagée dans un dépôt public en mai. Cette clé ouvrait une plateforme d’agent interne, qui détenait un jeton GitHub appartenant à un propriétaire d’organisation. À partir de là, l’attaquant a utilisé des flux de travail CI pour extraire plus de jetons. Ensuite, ils ont orienté la chaîne de libération vers un dépôt similaire.
C’est le dernier d’une série d’incidents similaires cette année. En mai, un groupe identifié par des chercheurs identifié comme TeamPCP a abusé du pipeline CI/CD de TanStack pour publier 84 versions malveillantes de paquets sous l’identité npm de confiance du projet. En août, la campagne ChainDrop a utilisé des identifiants volés pour se répartir sur des centaines de colis npm, dont beaucoup portaient une provenance valide.
Dans chaque cas, un logiciel de confiance est devenu une voie d’attaque tandis que les contrôles autour semblaient fonctionner. Une fois que le code malveillant a pris pied dans un environnement de confiance, où peut-il aller ensuite ? Un build runner peut détenir des identifiants cloud ou des autorisations de publication, et un service interne peut se connecter à des systèmes que ses appelants ne peuvent pas atteindre directement.
C’est pourquoi la sécurité de la chaîne d’approvisionnement logicielle doit désormais être traitée autant comme un problème de mouvement latéral que comme un problème de dépendance.
Le paquet n’est que le premier saut
Lorsqu’un composant tiers devient un problème de sécurité, les équipes commencent naturellement par le composant lui-même :
- Est-il vulnérable ?
- A-t-il été modifié ?
- Où est-ce qu’il tourne ?
- Existe-t-il une version sûre ?
Ces questions comptent, mais elles ne décrivent que le point d’entrée. Un package compromis s’exécutant dans une machine de développeur ou un environnement de compilation peut soudainement se retrouver à côté de crédents de contrôle de version, publiant des tokens, des identités cloud, des accès Kubernetes, des API internes et des chemins réseau vers d’autres systèmes.
À ce stade, le package a déjà accompli la partie essentielle en étant exécuté dans quelque chose de fiable. L’environnement détermine ce qui se passe ensuite.
Les équipes imaginent souvent le chemin d’attaque comme une ligne droite allant d’un package malveillant à une application compromise. Il est plus utile de retracer l’itinéraire complet : le package malveillant atterrit dans un environnement de confiance, récupère les identifiants et les accès disponibles là-bas, et les utilise pour atteindre d’autres systèmes.
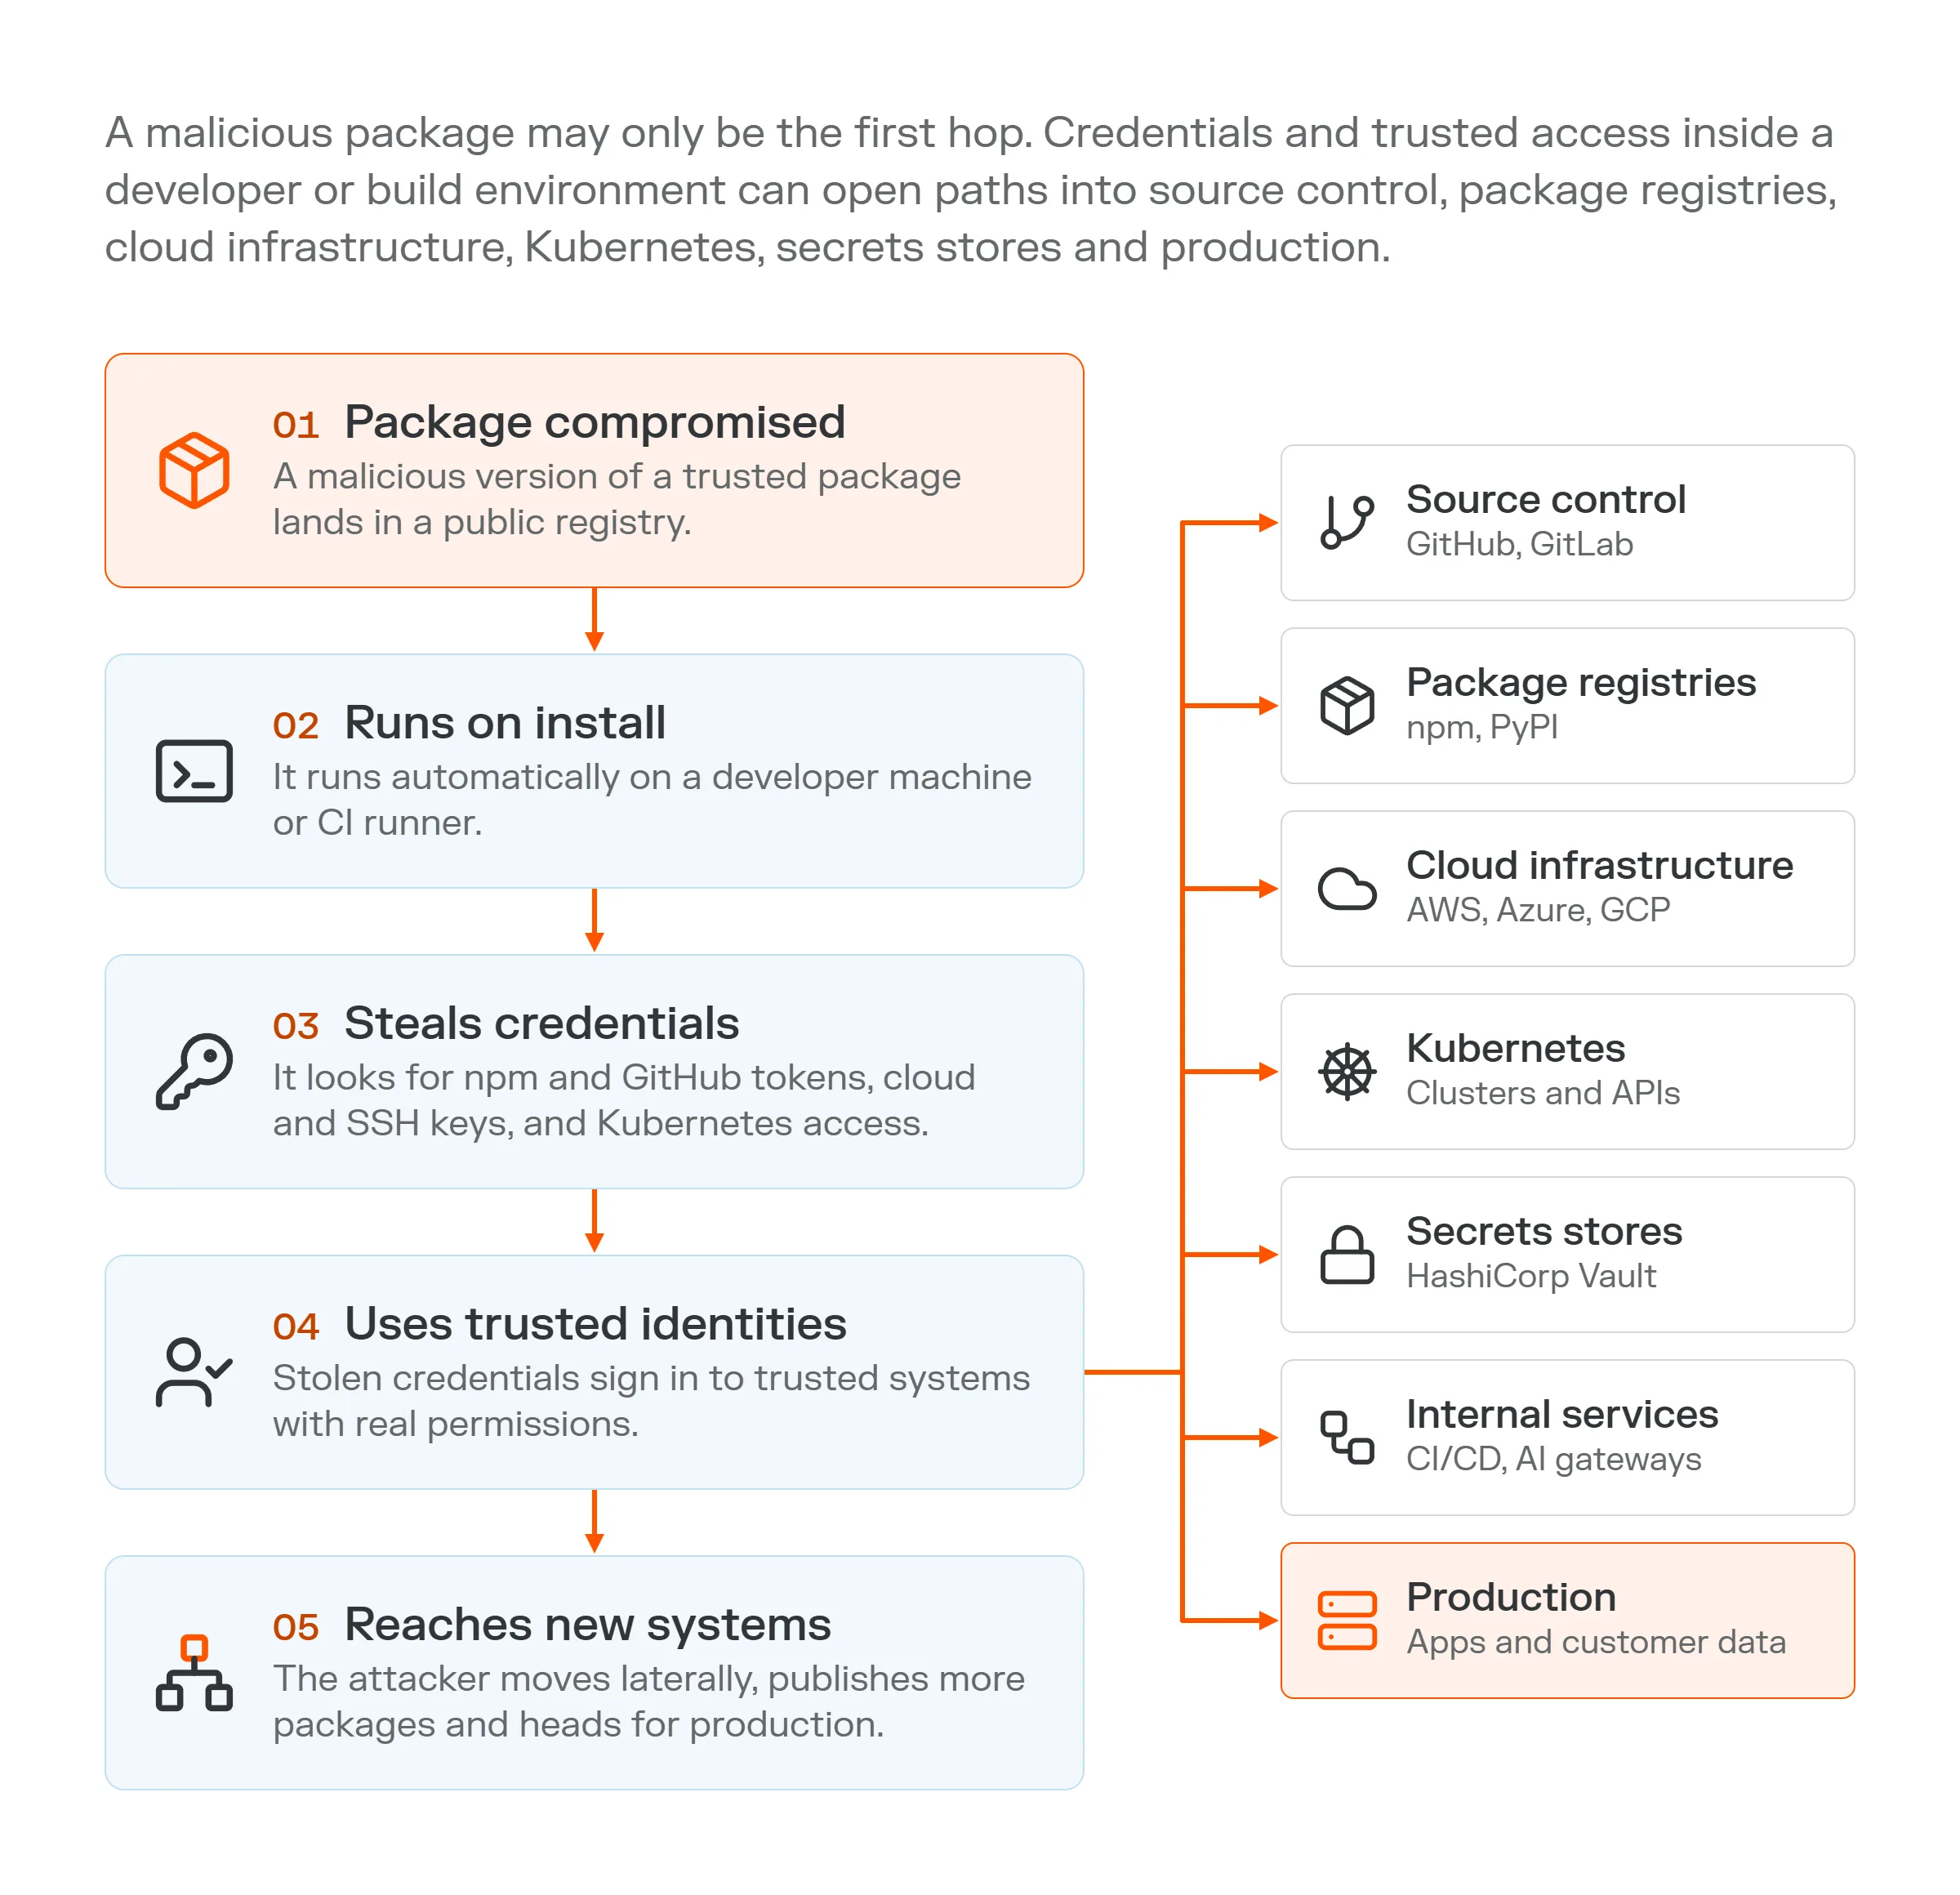
Un paquet malveillant peut n’être que le premier saut. Identifiants et accès fiables au sein d’un environnement développeur ou de build
peut créer des chemins vers le contrôle de version, les registres de paquets, l’infrastructure cloud, Kubernetes, les boutiques de secrets et la production.
Deux entreprises peuvent utiliser le même package compromis et obtenir des résultats très différents. Dans un environnement, le code malveillant peut ne pas avoir d’endroit utile où aller. Dans un autre, cela peut fonctionner parallèlement à de puissantes crédences et à une large connectivité interne.
Le pack offre un point d’appui. L’environnement détermine le rayon de l’explosion.
Le risque de se cacher au milieu
Les discussions sur la sécurité se concentrent souvent sur les deux extrémités de la chaîne d’approvisionnement logicielle : le composant tiers qui pourrait être compromis et le système de production que nous voulons protéger. Mais beaucoup de choses se situent entre eux.
Les dépôts d’artefacts, proxies de paquets, caches CI, plateformes de build, outils internes pour développeurs, passerelles IA, services secrets et autres infrastructures partagées relient différentes parties des environnements de développement et de production. Les équipes considèrent souvent ces systèmes comme des plomberies d’infrastructure, mais ils sont aussi des limites de sécurité.
Un service partagé peut être accessible dans de nombreux environnements. Il peut contenir des identifiants, stocker des données que d’autres charges de travail utilisent plus tard, ou se connecter à des systèmes que ses appelants ne peuvent pas atteindre directement. Une façon utile de penser ces systèmes est de s’agir de courtiers. Ils effectuent des travaux pour d’autres charges de travail, ce qui peut étendre la portée de l’appelant au-delà du courtier lui-même.
La plateforme d’agent interne de LiteLLM en est un exemple clair. Il existait pour ouvrir des pull requests, donc il contenait un jeton GitHub. Ce jeton appartenait à un propriétaire d’organisation, donc celui qui contrôlait la plateforme obtenait une portée au niveau du propriétaire dans les dépôts de l’entreprise.
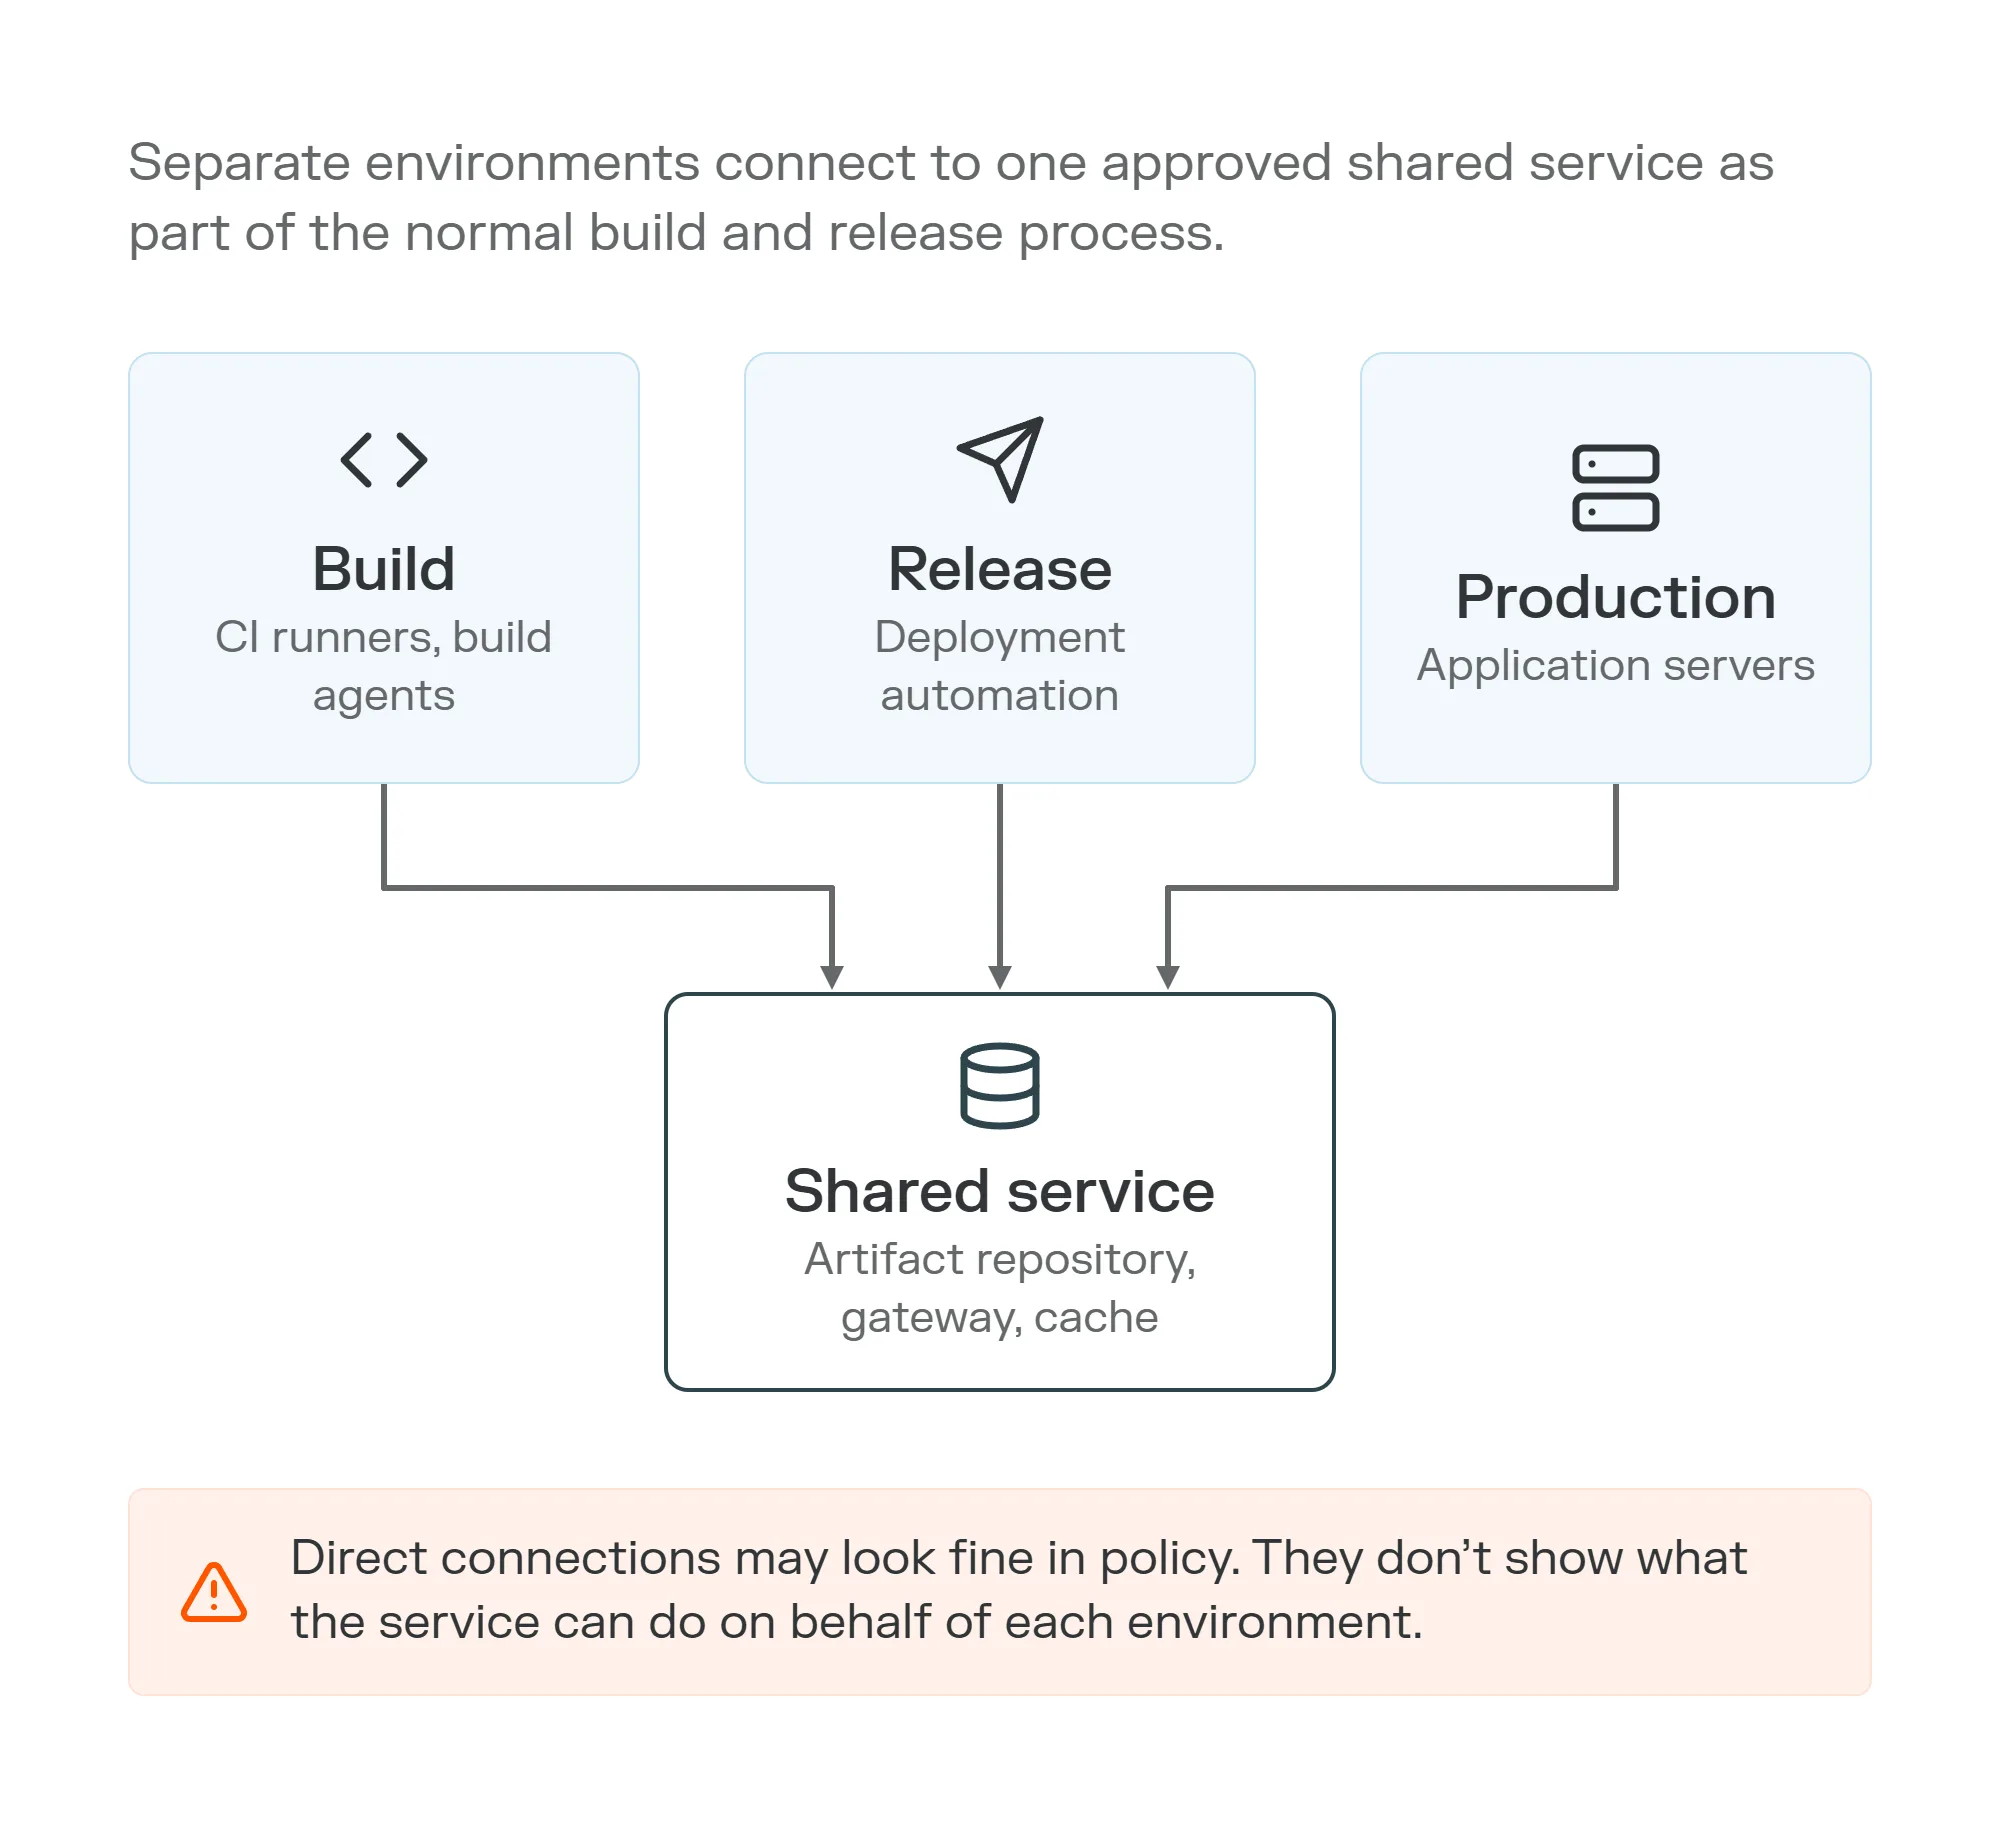
Processus de construction et de sortie. La construction, la sortie et la production ont chacun un lien approuvé vers un service partagé. Sur le papier, ils semblent bien séparés.
D’un point de vue politique, rien ne semble inhabituel : un environnement de compilation se connecte à un dépôt d’artefacts, un flux de travail de publication se connecte au même dépôt, et la production récupère les artefacts à partir de celui-ci. Chaque connexion peut être attendue et approuvée.
Le problème, c’est que la connectivité directe ne montre pas la pleine relation de confiance. Il ne nous dit pas ce que le service partagé peut faire, quel état il conserve, ni où il peut communiquer ensuite.
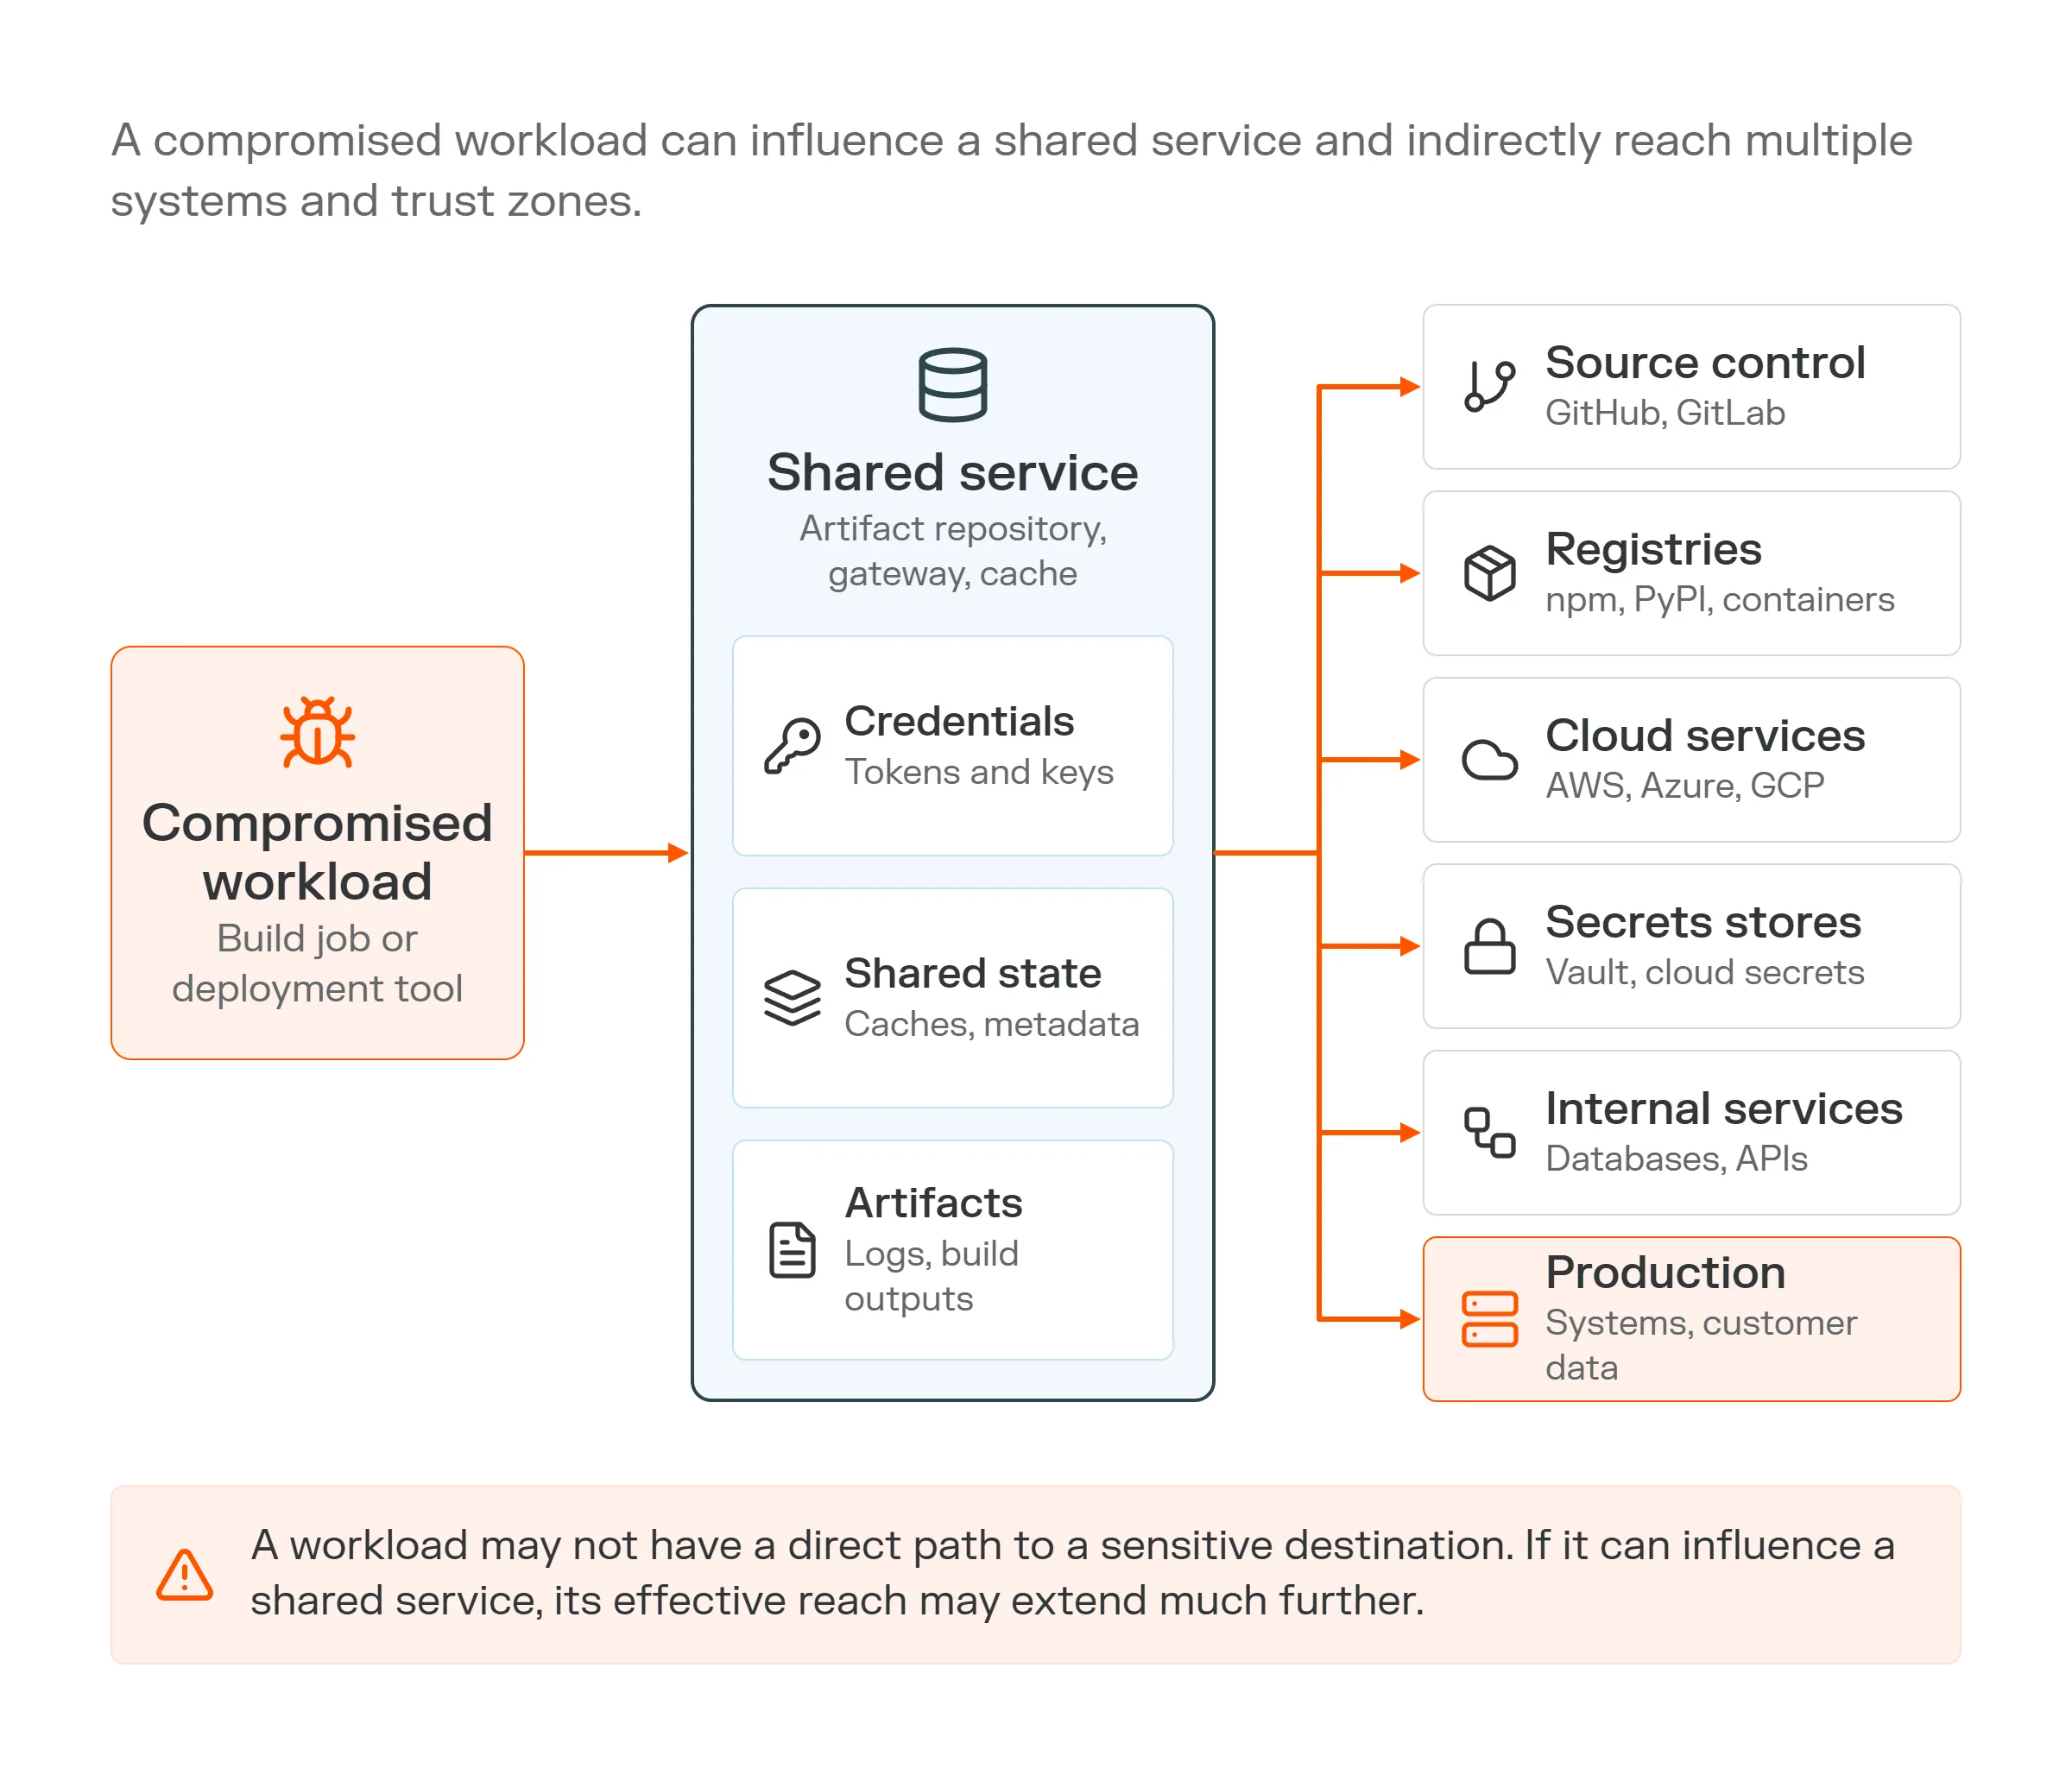
Des zones de confiance. Une charge de travail capable de diriger un service partagé peut atteindre tout ce que ce service peut atteindre, des identifiants à la production.
Une vue de visibilité pose trois questions supplémentaires :
- Que peut faire ce service avec une charge de travail ?
- Que peut faire le service en son nom ?
- Que conserve le service des autres charges de travail ?
Un proxy d’artefact peut se connecter à des registres externes. Un service de compilation peut récupérer la source, signer un artefact et le publier. Une passerelle peut se connecter à des API internes, des services cloud ou des bases de données. Une charge de travail peut donc ne pas avoir de lien direct avec un système sensible tout en pouvant influencer un service qui en a un.
L’État partagé compte aussi. Un cache écrit par un workflow peut ensuite être consommé par un autre, les logs peuvent conserver des identifiants, et des artefacts ou métadonnées peuvent se déplacer entre des environnements qui semblent autrement séparés. L’attaque TanStack a fonctionné ainsi. Le code provenant d’une pull request externe a empoisonné un cache de compilation partagé, et le flux de travail de publication du projet l’a restauré quelques heures plus tard.
Lorsqu’une charge de travail peut influencer un service partagé, sa portée peut s’étendre aux systèmes, aux identifiants et à l’état derrière ce service.
La prévention ne vous indique pas le rayon de l’explosion
Les équipes disposent déjà d’un ensemble solide d’outils pour réduire le risque dans la chaîne d’approvisionnement logicielle. Ils incluent la numérisation des dépendances, les certificats de documents logiciels (SBOM), les branches protégées, la signature d’artefacts, les attestations de compilation, la détection de malwares, la publication de confiance et les identités éphémères. Ces outils restent essentiels, mais la plupart sont conçus pour empêcher les attaquants d’entrer ou pour prouver que le code est fiable.
Ils ne répondent pas entièrement à ce qui se passe lorsque cette confiance échoue. L’identité d’un développeur peut être volée, un flux de travail de confiance peut être modifié, un processus de compilation légitime peut produire quelque chose de malveillant, ou un état partagé peut passer d’un environnement à faible confiance à un environnement à plus haute confiance.
C’est là que la prévention et le confinement répondent à différentes questions. La prévention demande si nous pouvons empêcher des logiciels malveillants d’y entrer. Le confinement demande jusqu’où le compromis peut atteindre si la prévention échoue.
Les deux appartiennent à la sécurité de la chaîne d’approvisionnement logicielle car la première prise n’est qu’une partie du résultat final.
Comment limiter ce qu’une compromission de la chaîne d’approvisionnement peut atteindre
Le confinement de la chaîne d’approvisionnement ne dépend pas d’un seul contrôle parfait. L’objectif est de réduire le nombre d’étapes suivantes utiles disponibles pour un attaquant après qu’un problème tourne, et ces quatre pratiques sont un bon point de départ.
Limitez la valeur des identifiants
Utilisez des identités à portée étroite et séparez les privilèges de construction, publication et déploiement lorsque cela est possible. Les accréditations éphémères aident, mais la portée compte tout autant car une habilitation qui n’existe que quelques minutes peut tout de même causer des dommages importants si elle dispose de permissions larges.
Séparez différents niveaux de confiance
Les flux de travail de développement, les compilations pull-request non fiables, les systèmes de publication et la production ne devraient pas automatiquement partager l’état manuscrit, les identifiants ou les privilèges. Lorsque l’infrastructure partagée est nécessaire, séparez autant que possible les autorisations et les politiques d’accès.
Réduire la connectivité inutile
Les systèmes de build ont souvent un accès réseau large car cela facilite l’ingénierie, mais le code malveillant reçoit ce même accès. Si une charge de travail n’a besoin que d’un petit nombre de destinations, ce sont ces chemins qu’elle obtient.
Le même principe s’applique aux services partagés. Un proxy d’artefact peut avoir besoin d’accéder à quelques registres, tandis qu’une passerelle interne peut nécessiter un ensemble défini d’API. Aucun des deux n’a besoin de connectivité sans restriction simplement parce qu’il est à l’intérieur du réseau.
C’est là que la segmentation devient particulièrement précieuse. Chaque chemin inutilement supprimé est un chemin de moins qu’un attaquant peut utiliser après la première prise d’appui.
Considérez l’infrastructure des développeurs comme une infrastructure sensible
Les systèmes d’IC, les dépôts d’artefacts, les portails développeurs, les passerelles d’IA et les services de build peuvent détenir des identifiants ou une connectivité aussi précieux que les systèmes en production. Protège-les en fonction de ce qu’ils peuvent atteindre et de ce qu’ils retiennent, qu’ils soient considérés comme internes ou non.
Commencez par le rayon d’explosion
Une façon simple d’appliquer cette réflexion est de choisir une station de travail développeur, un runner CI, un service de construction, une passerelle ou un dépôt d’artefacts et de supposer qu’elle a déjà été compromise.
Ensuite, ouvrez-vous et regardez ce qui sera disponible ensuite :
- Des références. Quels jetons, clés ou identités sont disponibles ?
- Accès. À quoi ces identités peuvent-elles s’authentifier ?
- La connectivité. Avec quels systèmes cet environnement peut-il communiquer ?
- Services partagés. Quels intermédiaires peut-il influencer, et qu’est-ce qu’ils peuvent atteindre ou retenir ?
- Au prochain saut. Un autre système expose-t-il une qualification, une identité ou un chemin supplémentaire ?
Cela transforme l’exercice, passant de la simple recherche d’un composant vulnérable à la compréhension d’un chemin d’attaque. Les résultats peuvent sembler petits individuellement, comme un rôle cloud trop privilégié, un jeton de publication qui aurait dû expirer, un cache partagé, un chemin réseau inutile ou un journal conservant les identifiants.
Ensemble, ces détails déterminent si le compromis s’arrête à une seule charge de travail ou s’étend beaucoup plus loin.
Où la violation peut-elle aller ensuite ?
Nous continuerons à dépendre de logiciels que nous n’avons pas écrits, donc le patching, la provenance, les pipelines de build sécurisés et la publication de confiance continueront d’être importants. Des plans de confinement pour le moment où l’un d’eux échoue.
Une fois que du code malveillant s’exécute à l’intérieur d’un objet de confiance, la question la plus importante devient de savoir où il peut aller ensuite.
Cela signifie examiner les identités autour de la charge de travail, les systèmes qu’elle peut atteindre, et les services partagés reliant différentes parties de l’environnement. La première prise peut être difficile à éviter à chaque fois, mais la suivante n’a pas besoin d’être automatique.
L’attaquant de LiteLLM avait besoin d’une chaîne de sauts pour atteindre PyPI : une clé fuitée, une plateforme interne, un jeton du propriétaire, une série de secrets CI volés, et enfin le flux de travail de libération. Chaque lien était une nouvelle occasion d’arrêter la propagation.
Un composant compromis doit rester un composant compromis.
Voyez comment Illumio vous aide à cartographier ce que chaque charge de travail peut atteindre et à fermer les chemins qu’un attaquant pourrait emprunter après la première prise de pied. Réservez une démonstration dès aujourd’hui.