Die Software-Lieferkette ist nun ein Problem der Lateral Movement
Am 21. Oktober verbreiteten Angreifer eine bösartige Veröffentlichung von LiteLLM, einer beliebten Python-Bibliothek mit etwa 23 Millionen wöchentlichen Downloads. Es wurde durch die eigene Release-Pipeline des Projekts an PyPI und seine offiziellen Docker-Images weitergeleitet.
Jeder, der das offizielle Quellcode-Tag auf GitHub überprüft hätte, hätte nichts falsch gefunden, denn die bösartigen Dateien haben es nie berührt.
Die vergiftete Freisetzung war der letzte Sprung des Angriffs. Die Ursachenanalyse von LiteLLM führt es auf einen Admin-Schlüssel zurück, der im Mai versehentlich in ein öffentliches Repository eingetragen wurde. Dieser Schlüssel öffnete eine interne Agentenplattform, die einen GitHub-Token eines Organisationsinhabers enthielt. Von dort aus nutzte der Angreifer CI-Workflows, um weitere Token zu ziehen. Dann richteten sie die Release-Pipeline auf ein Lookalike-Repository.
Es ist der jüngste in einer Reihe ähnlicher Vorfälle in diesem Jahr. Im Mai missbrauchte eine Forschergruppe, die sich als TeamPCP identifiziert, die CI/CD-Pipeline von TanStack , um 84 bösartige Paketversionen unter der vertrauenswürdigen npm-Identität des Projekts zu veröffentlichen. Im August nutzte die ChainDrop-Kampagne gestohlene Zugangsdaten, um sich auf Hunderte von npm-Paketen zu verteilen, von denen viele gültige Herkunft trugen.
In jedem Fall wurde vertrauenswürdige Software zu einem Angriffspfad, während die Steuerungen darum herum zu funktionieren schienen. Sobald bösartiger Code in einer vertrauenswürdigen Umgebung Fuß fasst, wohin kann er als Nächstes gehen? Ein Build-Runner kann Cloud-Zugangsdaten oder Veröffentlichungsrechte besitzen, und ein interner Dienst kann sich mit Systemen verbinden, die seine Anrufer nicht direkt erreichen können.
Deshalb muss die Sicherheit der Software-Lieferkette jetzt ebenso sehr als ein Problem der Lateral Movement wie als Abhängigkeitsproblem behandelt werden.
Das Paket ist nur der erste Hop
Wenn eine Drittanbieterkomponente zu einem Sicherheitsproblem wird, beginnen Teams natürlich mit der Komponente selbst:
- Ist es verwundbar?
- Wurde es modifiziert?
- Wo läuft es?
- Gibt es eine sichere Version?
Diese Fragen sind wichtig, aber sie beschreiben nur den Einstiegspunkt. Ein kompromittiertes Paket, das in einer Entwicklermaschine oder Build-Umgebung ausgeführt wird, kann plötzlich neben Quellcode-Zugangsdaten, Veröffentlichungstoken, Cloud-Identitäten, Kubernetes-Zugriffen, internen APIs und Netzwerkpfaden zu anderen Systemen liegen.
Zu diesem Zeitpunkt hat das Paket bereits den entscheidenden Teil geleistet, indem es in etwas Vertrauenswürdigem ausgeführt wird. Die Umgebung bestimmt, was als Nächstes passiert.
Teams stellen sich den Angriffsweg oft als eine gerade Linie von einem bösartigen Paket zu einer kompromittierten Anwendung vor. Es ist nützlicher, die gesamte Route zurückzuverfolgen: Das bösartige Paket landet in einer vertrauenswürdigen Umgebung, sammelt die dort verfügbaren Zugangsdaten und Zugriffe und nutzt sie, um weitere Systeme zu erreichen.
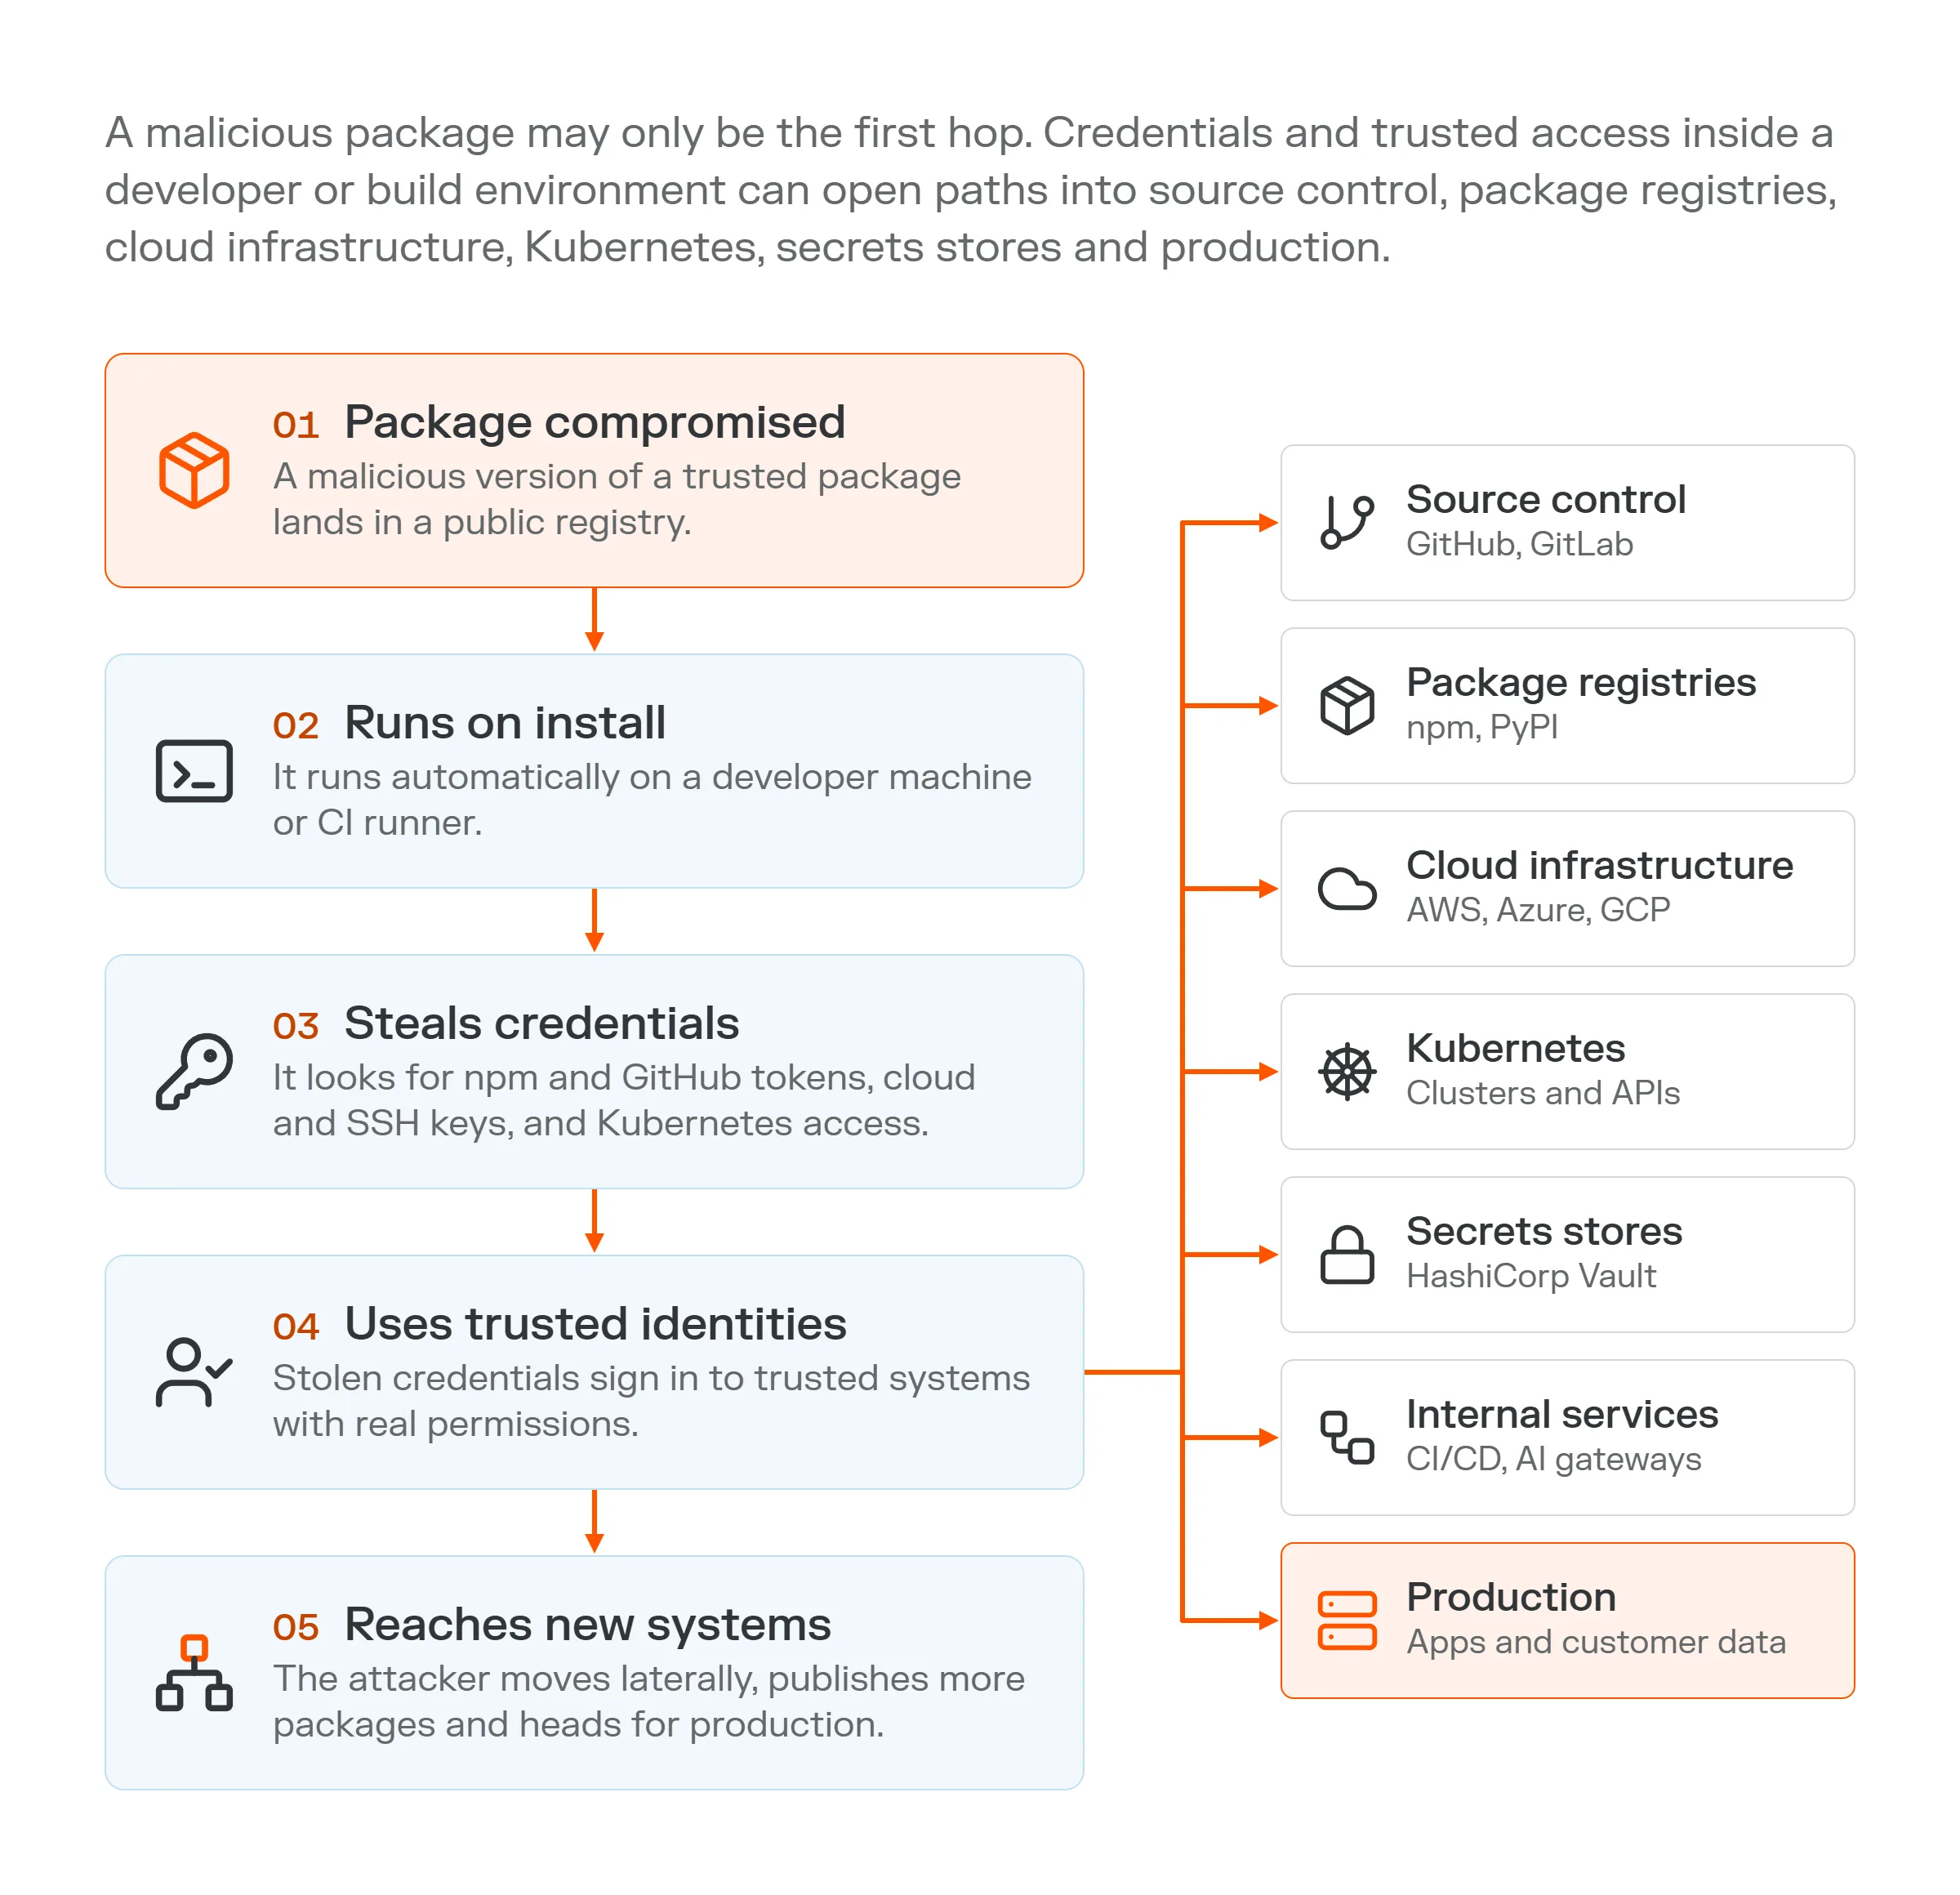
Ein bösartiges Paket ist vielleicht nur der erste Sprung. Zugangsdaten und vertrauenswürdiger Zugriff innerhalb einer Entwickler- oder Build-Umgebung
kann Pfade in Quellcode, Paketregistrierungen, Cloud-Infrastruktur, Kubernetes, Secrets-Speicher und Produktion erstellen.
Zwei Unternehmen können dasselbe kompromittierte Paket betreiben und sehr unterschiedliche Ergebnisse erzielen. In einer Umgebung hat der bösartige Code möglicherweise keinen nützlichen Ort. In einer anderen kann es neben leistungsstarken Qualifikationen und einer breiten internen Vernetzung laufen.
Das Paket bietet den Halt. Die Umgebung bestimmt den Explosionsradius.
Das Risiko, sich in der Mitte zu verstecken
Sicherheitsdiskussionen konzentrieren sich oft auf die beiden Enden der Software-Lieferkette: die möglicherweise kompromittierte Drittanbieterkomponente und das Produktionssystem, das wir schützen wollen. Aber viel liegt zwischen ihnen.
Artefakt-Repositories, Paket-Proxys, CI-Caches, Bauplattformen, interne Entwicklertools, KI-Gateways, Secrets-Services und andere gemeinsame Infrastrukturen verbinden verschiedene Teile von Entwicklungs- und Produktionsumgebungen. Teams behandeln diese Systeme oft als Infrastrukturleitungen, aber sie sind auch Sicherheitsgrenzen.
Ein gemeinsamer Dienst kann von vielen Umgebungen erreichbar sein. Es kann Zugangsdaten speichern, Daten speichern, die andere Workloads später verwenden, oder sich mit Systemen verbinden, die seine Anrufer nicht direkt erreichen können. Eine nützliche Möglichkeit, diese Systeme zu betrachten, ist als Makler. Sie übernehmen Aufgaben im Auftrag anderer Workloads, was die Reichweite eines Anrufers über den Broker hinaus erweitern kann.
Die interne Agentenplattform von LiteLLM ist ein klares Beispiel. Es existierte, um Pull-Anfragen zu öffnen, also enthielt es ein GitHub-Token. Dieser Token gehörte einem Organisationsinhaber, sodass derjenige, der die Plattform kontrollierte, eine Reichweite auf Eigentümerebene in den Repositorien des Unternehmens erhielt.
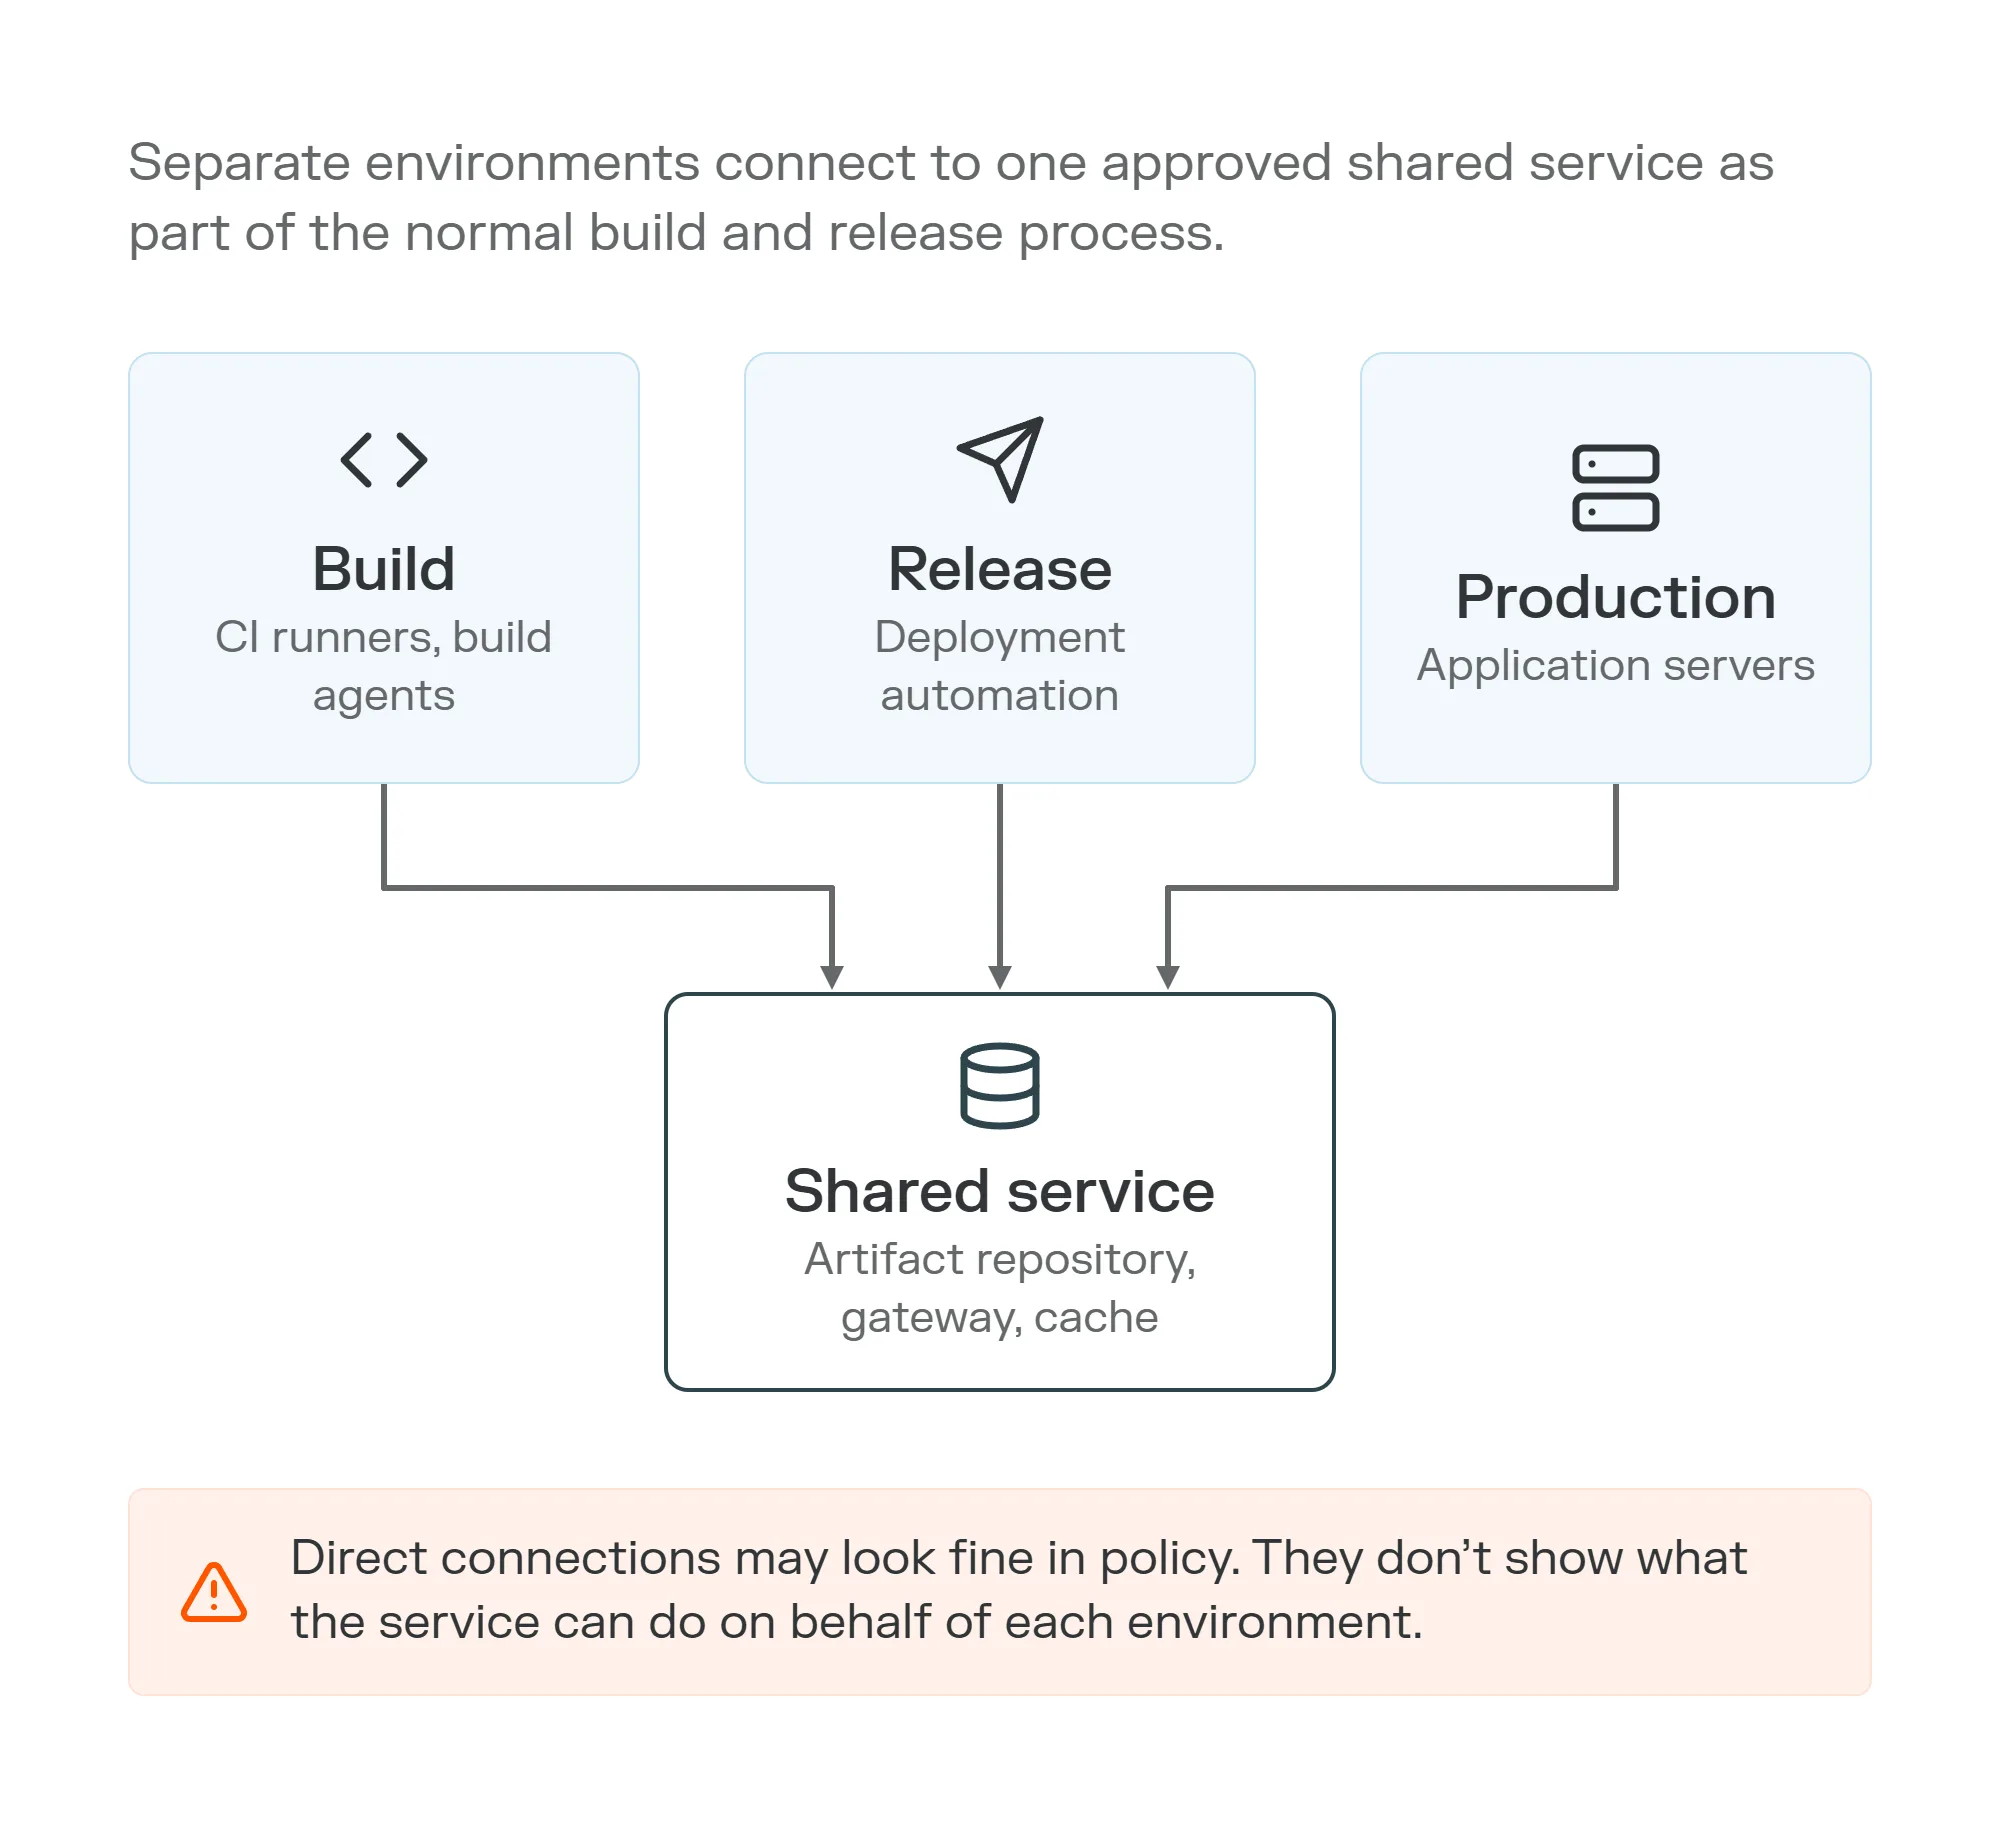
Bau- und Veröffentlichungsprozess. Build, Release und Production haben jeweils einen genehmigten Link zu einem gemeinsamen Dienst. Auf dem Papier wirken sie gut getrennt.
Aus Richtliniensicht sieht nichts ungewöhnlich aus: Eine Build-Umgebung verbindet sich mit einem Artefakt-Repository, ein Release-Workflow verbindet sich mit demselben Repository, und die Produktion ruft Artefakte daraus ab. Jede Verbindung kann erwartet und genehmigt werden.
Das Problem ist, dass direkte Verbindung nicht die volle Vertrauensbeziehung zeigt. Es sagt uns nicht, was der gemeinsame Dienst kann, welchen Zustand er beibehält oder wo er als Nächstes kommunizieren kann.
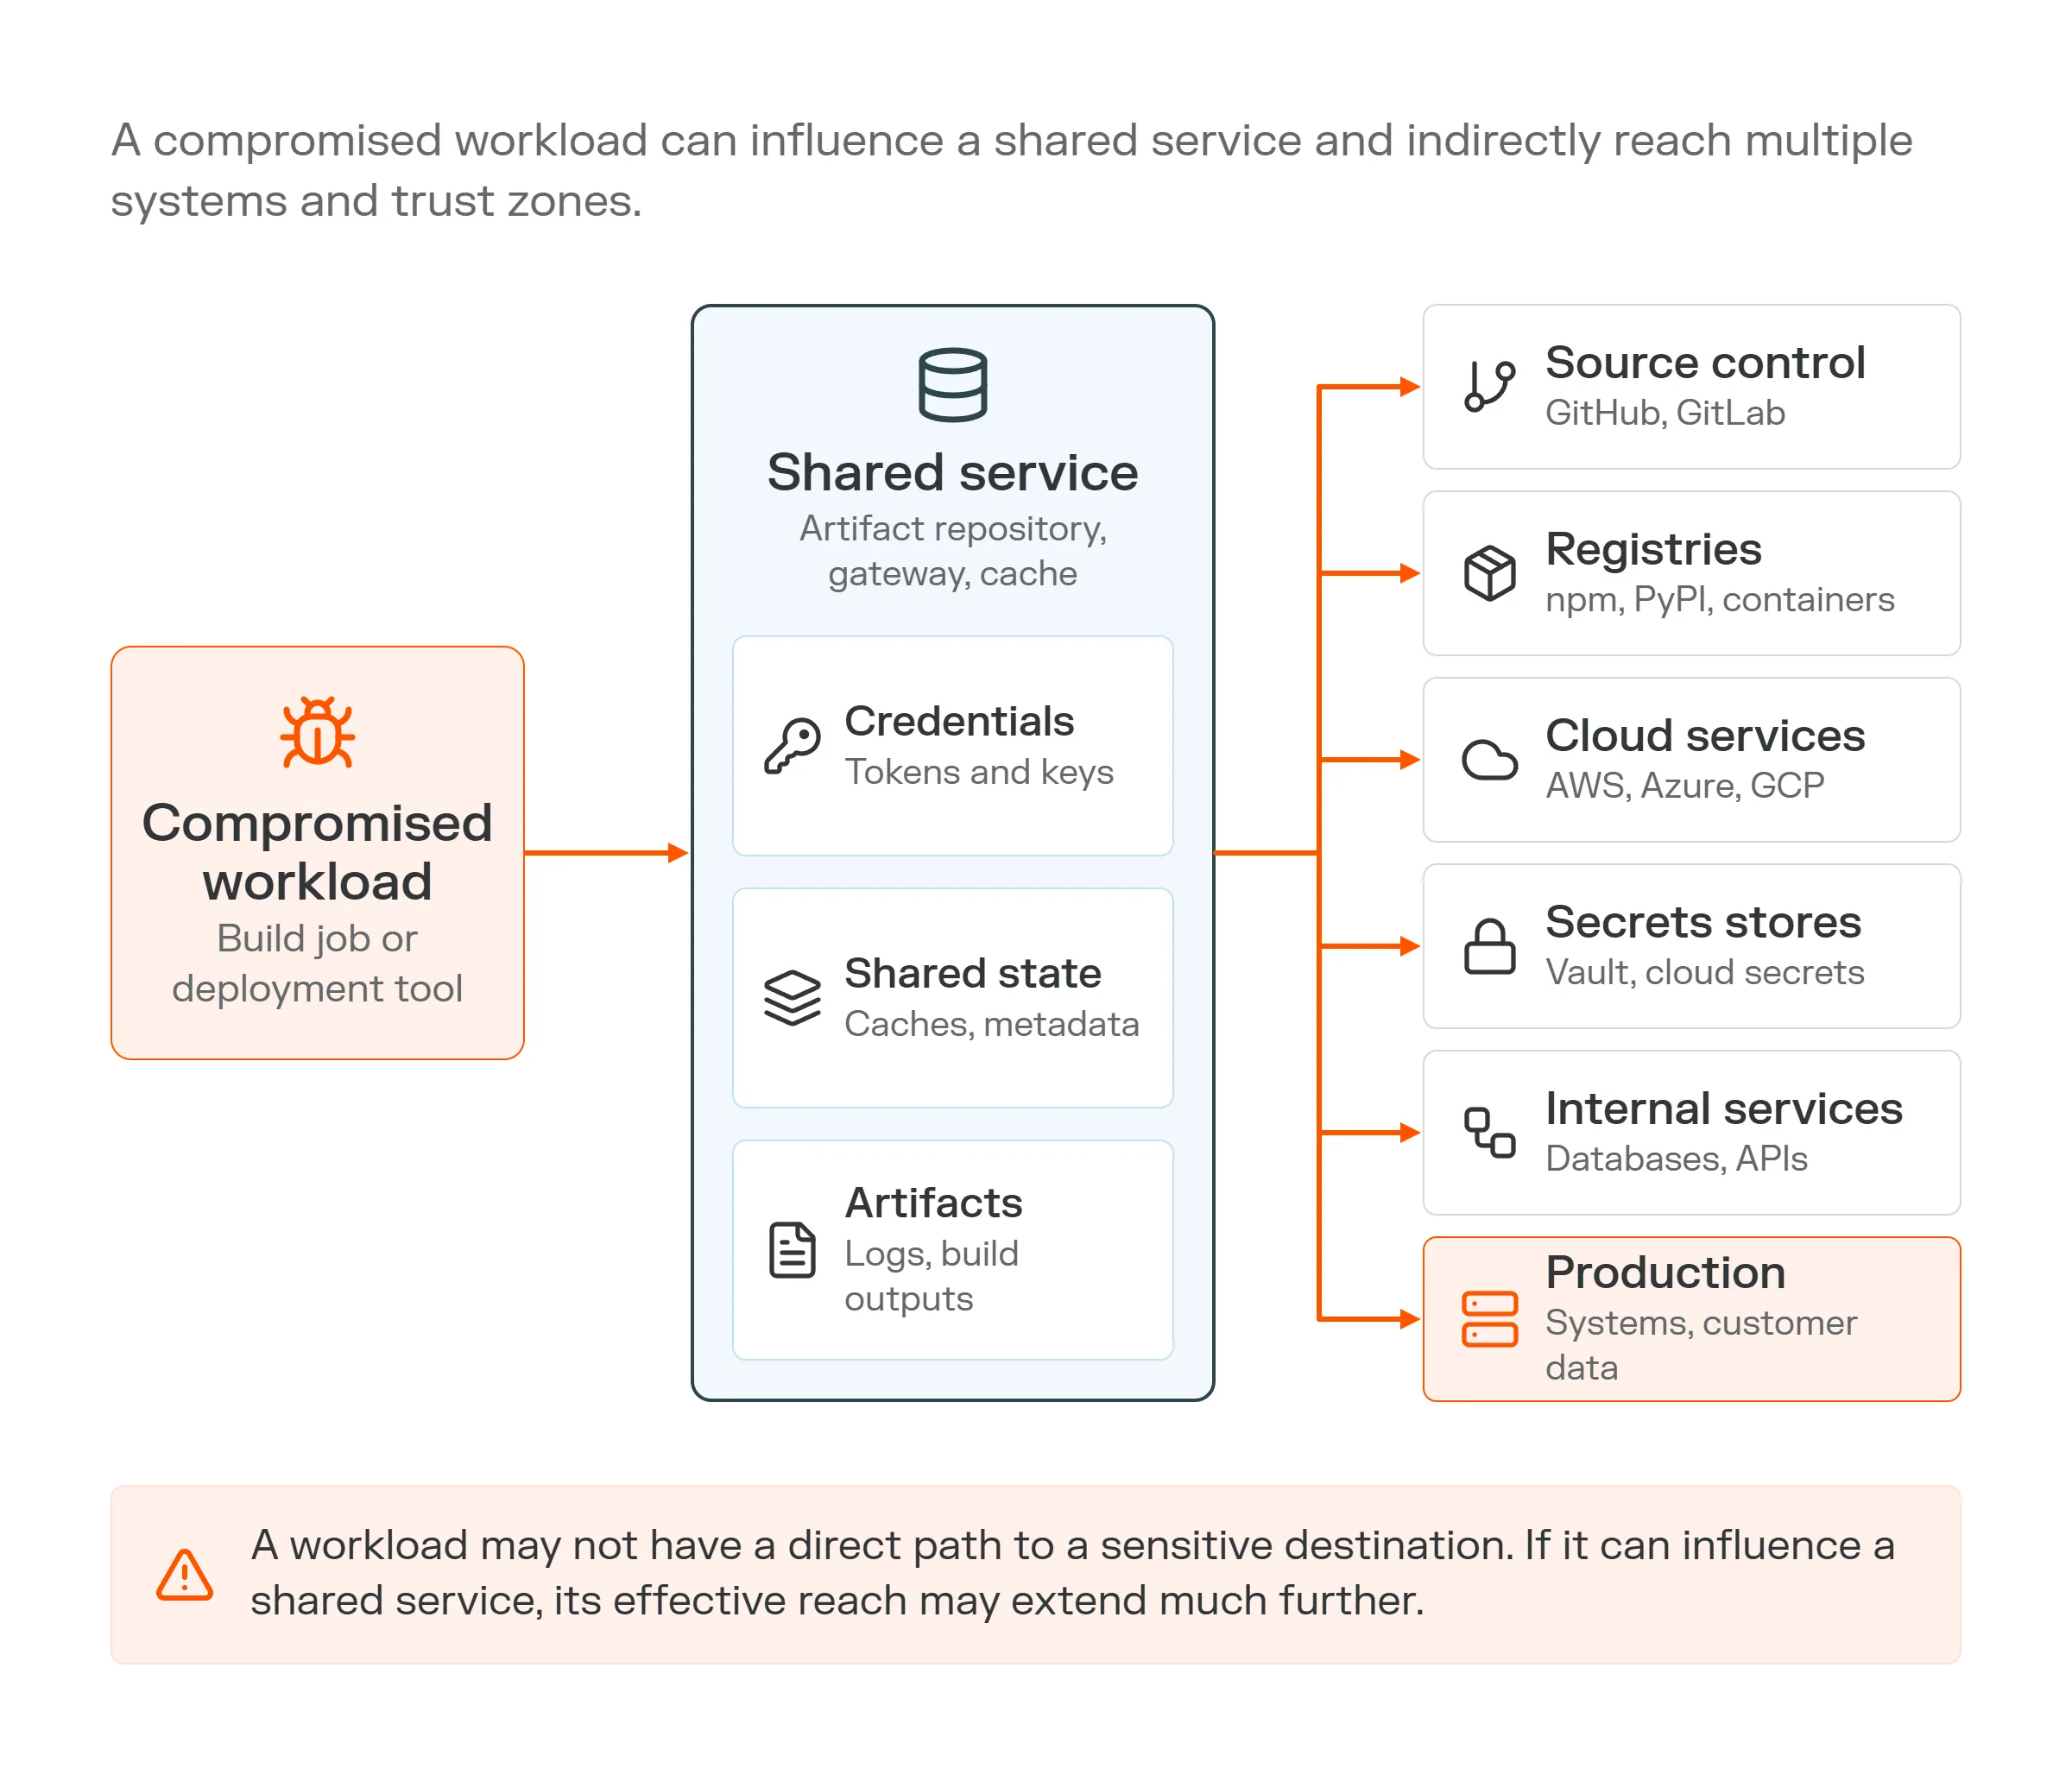
Vertrauenszonen. Eine Arbeitslast, die einen gemeinsamen Dienst steuern kann, kann alles erreichen, was dieser Dienst erreichen kann, von Zugangsdaten bis zur Produktion.
Eine Erreichbarkeitsansicht stellt drei zusätzliche Fragen:
- Was kann eine Arbeitsbelastung für diesen Dienst leisten?
- Was kann der Dienst in seinem Namen erreichen?
- Was behält der Dienst von anderen Workloads?
Ein Artefakt-Proxy kann sich mit externen Registern verbinden. Ein Build-Service kann Quellcode abrufen, ein Artefakt signieren und veröffentlichen. Ein Gateway kann sich mit internen APIs, Cloud-Diensten oder Datenbanken verbinden. Eine Arbeitslast kann daher keine direkte Verbindung zu einem sensiblen System haben, kann aber dennoch Einfluss auf einen Dienst haben, der dies tut.
Auch der gemeinsame Staat ist wichtig. Ein von einem Workflow geschriebener Cache kann später von einem anderen genutzt werden, Logs können Zugangsdaten behalten, und Artefakte oder Metadaten können zwischen Umgebungen übertragen werden, die sonst getrennt erscheinen. Der TanStack-Angriff funktionierte so. Code von einem externen Pull-Request hat einen gemeinsamen Build-Cache vergiftet, und der Release-Workflow des Projekts stellte ihn Stunden später wieder her.
Wenn eine Workloads einen gemeinsamen Dienst beeinflussen kann, kann sich deren Reichweite auf die Systeme, Zugangsdaten und den Staat hinter diesem Dienst erstrecken.
Die Prävention sagt dir den Explosionsradius nicht
Teams verfügen bereits über einen starken Satz an Werkzeugen, um das Risiko der Software-Lieferkette zu reduzieren. Dazu gehören Abhängigkeitsscans, Softwarestücklisten (SBOMs), geschützte Zweige, Artefaktsignierung, Build-Attestationen, Malware-Erkennung, Trusted Publishing und kurzlebige Identitäten. Diese Werkzeuge sind weiterhin unerlässlich, aber die meisten sind darauf ausgelegt, Angreifer fernzuhalten oder zu beweisen, dass Code vertrauenswürdig ist.
Sie beantworten nicht vollständig, was passiert, wenn dieses Vertrauen scheitert. Eine Entwickleridentität kann gestohlen werden, ein vertrauenswürdiger Workflow kann modifiziert werden, ein legitimer Build-Prozess kann etwas Bösartiges erzeugen oder der gemeinsame Zustand kann von einer Umgebung mit niedrigerem Vertrauen in eine mit höherer Vertrauensstärke übergehen.
Hier beantworten Prävention und Eindämmung verschiedene Fragen. Prävention fragt, ob wir bösartige Software am Eindringen hindern können. Die Eindämmung fragt, wie weit der Kompromiss reichen kann, falls die Prävention scheitert.
Beide gehören zur Sicherheit der Software-Lieferkette, da der anfängliche Fuß nur ein Teil des Endergebnisses ist.
Wie man begrenzt, was ein Kompromiss in der Lieferkette erreichen kann
Die Eindämmung der Lieferkette hängt nicht von einer perfekten Kontrolle ab. Das Ziel ist es, die Anzahl nützlicher nächster Schritte zu reduzieren, die einem Angreifer nach einem Fehltritt zur Verfügung stehen, und diese vier Praktiken sind ein guter Ausgangspunkt.
Begrenze den Wert der Zugangsdaten
Verwenden Sie eng gefasste Identitäten und separate Build-, Publicing- und Deployment-Rechte, wo immer es möglich ist. Kurzzeitige Zugangsdaten helfen, aber der Umfang ist genauso wichtig, denn ein Zugangsnachweis, der nur wenige Minuten existiert, kann auch erheblichen Schaden anrichten, wenn er weitreichende Berechtigungen hat.
Trennen Sie verschiedene Vertrauensstufen
Entwicklungsworkflows, nicht vertrauenswürdige Pull-Request-Builds, Release-Systeme und Produktion sollten nicht automatisch beschreibbaren Zustand, Zugangsdaten oder Privilegien teilen. Wo gemeinsame Infrastruktur notwendig ist, sollten Berechtigungen und Zugriffsrichtlinien so weit wie möglich getrennt werden.
Reduzieren Sie unnötige Konnektivität
Build-Systeme haben oft breiten Netzwerkzugriff, weil das die Entwicklung erleichtert, aber bösartiger Code erhält denselben Zugriff. Wenn eine Arbeitslast nur eine kleine Anzahl von Zielen benötigt, sollten das die Pfade sein, die sie bekommt.
Das gleiche Prinzip gilt für gemeinsame Dienste. Ein Artefakt-Proxy benötigt möglicherweise Zugriff auf einige Register, während ein internes Gateway einen definierten Satz von APIs benötigt. Keiner von beiden benötigt uneingeschränkte Konnektivität, nur weil sie im Netzwerk liegt.
Hier wird Segmentierung besonders wertvoll. Jeder unnötige entfernte Pfad ist ein Pfad weniger, den ein Angreifer nach dem ersten Stich nutzen kann.
Behandle die Entwicklerinfrastruktur als sensible Infrastruktur
CI-Systeme, Artefakt-Repositorien, Entwicklerportale, KI-Gateways und Build-Services können Zugangsdaten oder Konnektivität ebenso wertvoll haben wie Systeme in der Produktion. Schützen Sie sie danach, was sie erreichen können und was sie behalten, egal ob sie als intern gelten oder nicht.
Fang mit dem Explosionsradius an
Eine einfache Methode, dieses Denken anzuwenden, besteht darin, eine Entwickler-Workstation, einen CI-Runner, einen Build-Service-, ein Gateway- oder Artefakt-Repository auszuwählen und davon auszugehen, dass es bereits kompromittiert wurde.
Dann gehen Sie nach draußen und schauen Sie, was als Nächstes verfügbar wird:
- Qualifikationen. Welche Tokens, Schlüssel oder Identitäten sind verfügbar?
- Zugang. Worauf können diese Identitäten authentifiziert werden?
- Verbindung. Mit welchen Systemen kann diese Umgebung kommunizieren?
- Gemeinsame Dienste. Welche Vermittler kann es beeinflussen, und was können sie erreichen oder behalten?
- Nächster Hop. Gibt ein anderes System eine zusätzliche Zugangsberechtigung, Identität oder einen weiteren Weg frei?
Das verändert die Übung von der bloßen Suche nach einer verwundbaren Komponente hin zum Verständnis eines Angriffspfads. Die Ergebnisse können einzeln klein erscheinen, wie etwa eine überprivilegierte Cloud-Rolle, ein Veröffentlichungstoken, der eigentlich abgelaufen sein sollte, ein gemeinsamer Cache, ein unnötiger Netzwerkpfad oder eine Log-Speicherzugangsdaten.
Zusammen entscheiden diese Details, ob der Kompromiss bei einer Workloads endet oder sich viel weiter ausbreitet.
Wohin kann die Sicherheitsverletzung als Nächstes gehen?
Wir werden weiterhin auf Software vertrauen, die wir nicht geschrieben haben, daher werden Patches, Herkunft, sichere Build-Pipelines und Trusted Publishing weiterhin wichtig sein. Eindämmungspläne für den Moment, in dem einer von ihnen scheitert.
Sobald bösartiger Code in etwas Vertrauenswürdigem läuft, stellt sich die wichtigste Frage, wohin er als Nächstes gehen kann.
Das bedeutet, die Identitäten rund um die Workloads, die erreichten Systeme und die gemeinsamen Dienste zu betrachten, die verschiedene Teile der Umgebung verbinden. Der erste Tritt ist vielleicht jedes Mal schwer zu verhindern, aber der nächste muss nicht automatisch sein.
Der Angreifer von LiteLLM benötigte eine Kette von Hops, um PyPI zu erreichen: einen geleakten Schlüssel, eine interne Plattform, ein Inhaber-Token, eine Runde gestohlener CI-Geheimnisse und schließlich den Release-Workflow. Jede Verbindung war eine weitere Chance, die Ausbreitung zu stoppen.
Eine kompromittierte Komponente sollte eine kompromittierte Komponente bleiben.
Sieh dir an, wie Illumio dir hilft, zu kartieren, was jede Workloads erreichen kann, und die Pfade zu schließen, die ein Angreifer nach dem ersten Fußtritt nutzen könnte. Buchen Sie noch heute eine Demo.