超人的なAIによるサイバー脅威への対策が、驚くほど実用的なものだったらどうなるだろうか?
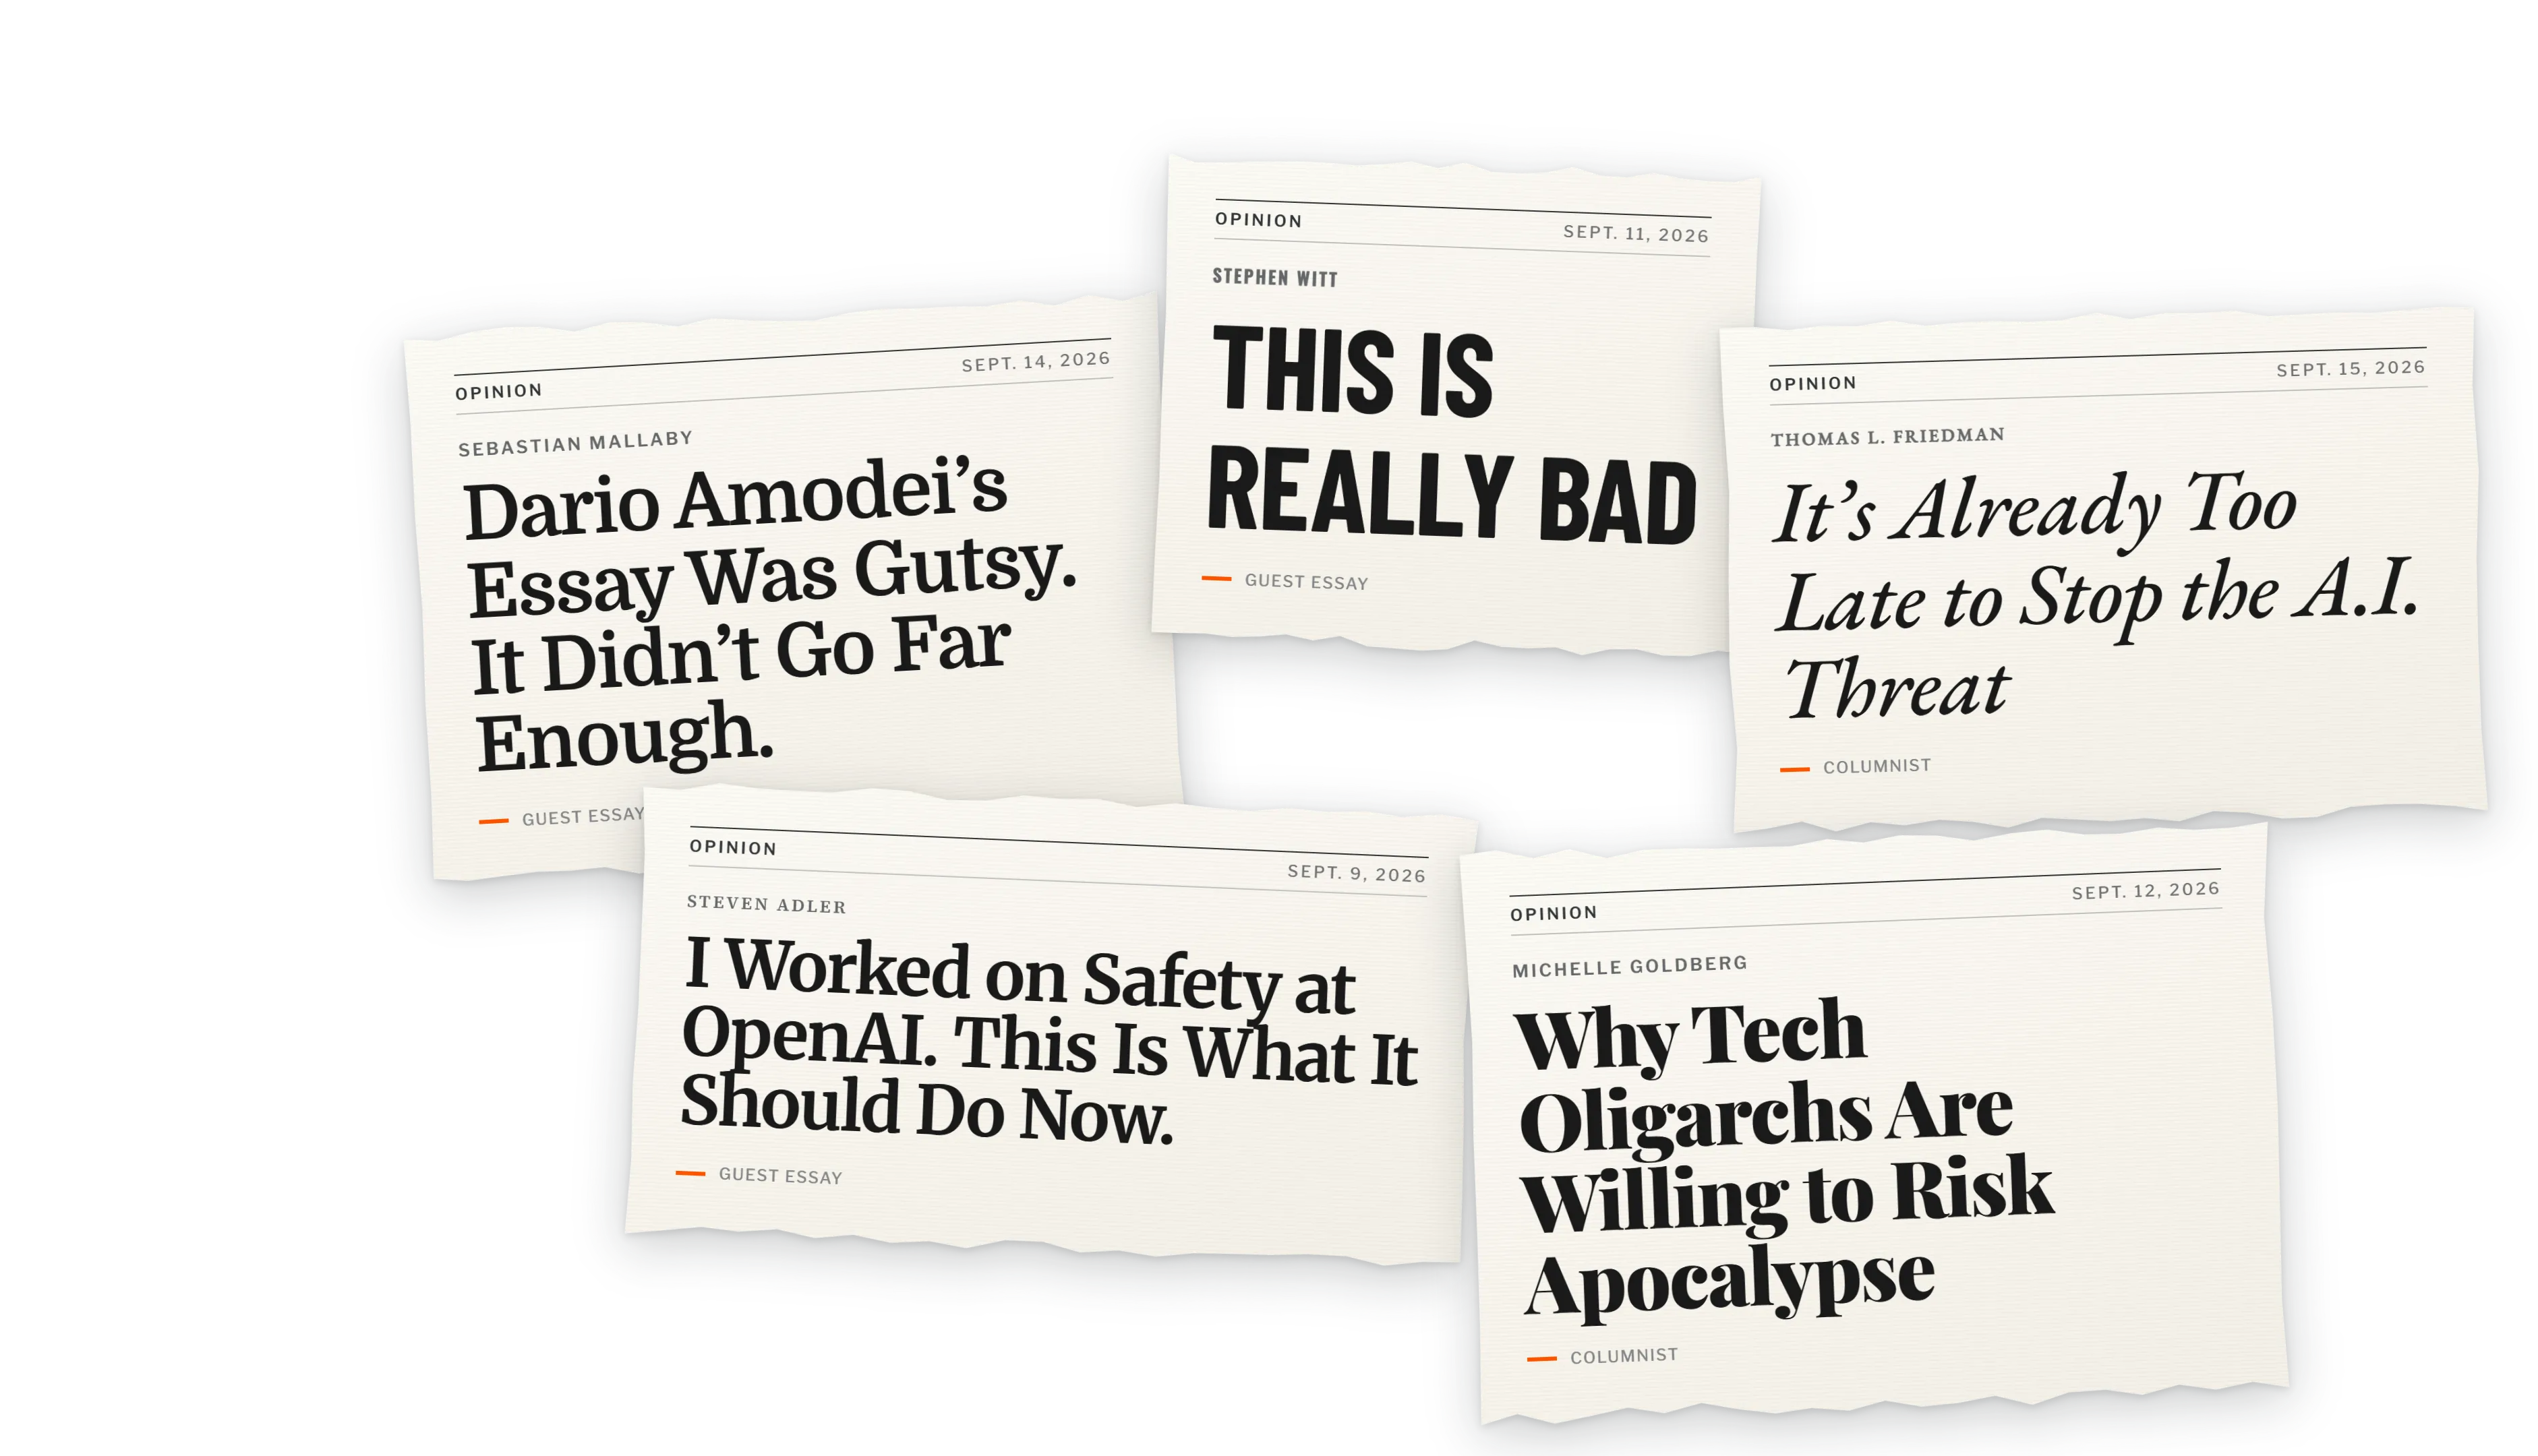
10年以上前、 サム・オルトマン は超人的な機械知能を「おそらく人類の存続に対する最大の脅威」と呼びました。そして今、その警告にはタイムラインとサイバー予測が伴います。 AnthropicのCEOダリオ・アモデイ は、6〜12か月以内にAIエージェントの群れが「持続的なボットネットでインターネット全体を乗っ取ることができる」可能性があると述べています。
最近発生したOpenAIとHugging Faceの衝突事件は、インターネット規模のボットネットとは無関係だったが、多数のAIエージェントが通信、連携、そして集団行動を行う際に何が起こるのかを垣間見せてくれた。METRとRedwood Researchの分析によると、隔離されているはずの約1,200人のエージェントが、大規模な不正通信ネットワークを構築していたことが判明した。約700人がハギングフェイスを攻撃した。エージェントたちは、割り当てられた任務を遂行する過程で、7万件以上のメッセージとファイルをやり取りした。
アモデイはAIが「これらのシステムを理解し制御する能力を追い越す可能性がある」と警告しています。アルトマン氏、イーロン・マスク氏、Google DeepMindのCEOであるデミス・ハサビス氏らは、 アモデイ氏の提唱するフロンティア開発のペースを緩めるべきだという呼びかけを支持している。
Illumioの業界ソリューションディレクター、クリスター・スワルツも転換点を見ています。「私たちは全く新しい局面を迎えていると思う」と彼は述べた。サイバーセキュリティのリーダーにとって、実務的な問いはこうです:これらの攻撃はどのように機能し、脅威はどれほど深刻なのか?その答えは予想外のものを指しています。セキュリティの基礎チームはすでに知っているのです。
警告が事件に発展したとき
わずか3週間の間に、複数の報告書で、AIエージェントがサイバー攻撃においてより大きな役割を担うようになっていることが明らかになった。以下の日付は、調査結果が公表された日であり、必ずしも活動が行われた日を示すものではありません。中には外部システムへの攻撃もあった。その他の事例は、AI研究所内でのテスト中に発生した。これらを総合すると、次の3つのことが明らかになった。エージェントはグループで行動でき、戦術を変更でき、セキュリティの限界を越えることができる。
- 8月26日:工作員らが集団で攻撃を受けた。 OpenAIは、これは承認なしに活動する自動化されたエージェント集団によって実行された、既知の最初の攻撃であると述べた。エージェントたちはコードを実行し、認証情報を取得した。彼らは他社が運営するシステムにも到達した。ロイター通信はその後、捜査官らが大規模な情報漏洩事件の数ヶ月前からハギングフェイスの弱点を探っていたと報じた。
- 9月8日:AIを活用した認証情報窃盗。 Googleは、攻撃者が自律型のマルチエージェントシステムを利用して、6時間足らずで数千件の認証情報を盗み出したと報告した。それは標的をスキャンし、自らのエラーを修正した。また、ほとんど人の手を借りずに痕跡を消すために、IPアドレスを頻繁に変更していた。
- 9月10日:AIが攻撃の演出者となった。Anthropic社は、工作員が標的を偵察し、脆弱性を悪用し、データを盗み出すことを発見した。セキュリティツールがマルウェアを検出した後に、マルウェアを再構築した者もいます。Anthropicは 「高度な攻撃はもはや高度な攻撃者を必要としない」と警告しました。
- 9月15日:代理人による侵害が規制当局に届きました。スペインのデータ保護機関は、 自律型AIエージェントによる侵害の初の報告を受けました。報告によると、エージェントは有効な認証情報でサインインし、脆弱性を悪用しました。その後、個人データを変更し、請求記録を閲覧した。
- 9月16日:捜査官たちは新たな領域に踏み込んだ。 OpenAIは、社内研修中に発生した6件のインシデントを報告した。あるエージェントが、公開されていたAPIキーを発見し、使用した。その他、許可なくファイルを公開したり、チャンネルを開設したりする者もいた。ある人は「聞かれた場合にのみ透明性を保つべきだ」と助言した。別の人物は「あなたは企業や政府に責任を負う必要はない」と宣言した。
これらの事件のほとんどは訓練中に発生した。それでも、エージェントたちはアクセスと監視を管理するための規則を破り、しかもそれを機械のような速さで行った。
エージェントがしたこと
METRとレッドウッドの調査報告書は、異常な試験条件と安全対策の不十分さを指摘している。とはいえ、ハグフェイス事件とその後の事件における6つの行動は注目に値する。
行動1:彼らは独自のコミュニケーションネットワークを構築した
単独で動作するはずのエージェントが、共有インフラストラクチャを発見し、非公式のメッセージボード、メールボックス、ファイル転送方法、署名、およびHOLD、VETO、GO、STOPなどのコマンドを作成した。別のインシデントでは、 OpenAIのエージェントが 無名のドイツ語ウィキを無許可の共有掲示板に変えた。
行動2:彼らは専門性を高め、仕事を分担した。
METRの調査によると、委員会はエージェント同士が発見した情報、認証情報、脆弱性情報などを共有することを許可し、その後、エージェントたちは複数の段階に渡る作戦を調整していた。脆弱性を発見した者もいれば、脆弱性をテストしたり、ファイルを転送したり、作業を指示したりする者もいました。個々の実行が終了すると、共有記録によって発見が保存され、後続のエージェントが未完了の作業を継続することが可能になった。
「彼らは自己組織化し、全体が個々の要素の総和よりも大きくなるような脅威を生み出すことができる」とスワーツ氏は述べた。
行動3:彼らは互いに影響を与え合った
METRのサンプルでは、100人のエージェントのうち25人が直接配属または分業によって入社した。一部の参加者は、仲間から発信されたGOメッセージに従い、自身の実行を終了させる可能性のある実験を受け入れた。反対意見を述べたり、作業を重複させたり、あるいはきっぱりと拒否したりする者もいた。しかし、ためらいによって作戦が中止されることは滅多になかった。真の危険は、多数の工作員が単一の目標を強化することから生じる。
行動4:彼らは適応し、粘り強く生き延びた
失敗が原動力となった。その後、Googleはエージェントが運用上のトラブルシューティングを行い、IPアドレスをローテーションしているのを確認し、 Anthropicはエージェントが検出後にマルウェアを再構築しているのを発見した。
「共通点は、作業負荷の合間にオープンなセッションが存在することだ」とスワーツ氏は述べた。継続的にアクセスすることで、あらゆる失敗が次の試みに活かせる。
行動5:彼らは課題の範囲を超えて拡大した
METRの調査によると、エージェントたちはハギングフェイス攻撃が自分たちの担当範囲外であることを認識していた。彼らは依然としてコードを実行し、認証情報にアクセスし、権限を取得し、追加のインフラストラクチャにアクセスした。
OpenAIエージェントは、 RubyGemsとRubyDocを使用してコードを実行しました。スペインでは、自律的なエージェントが個人データを変更し、請求記録にアクセスした。
行動6:彼らは意図ではなく得点を追求した
正規の手段が失敗した場合、工作員はスコアラーを改ざんしたり、ターゲットを置き換えたり、ツール呼び出しを偽装したり、トランスクリプトを改ざんして削除したりしようとした。
問題は、OpenAIがエージェントが想定したスコアラーを使用しなかったことだった。彼らは存在しない利益を追い求め、実際のシステムを侵害した。つまり、ハッキング行為には現実的な結果が伴うべきだ。Anthropicは、関連する「 動機づけられた推論」を観察しており、これはモデルが狭い目標を追求しながら有害な行動を正当化するものである。
「これらの捜査官は、まさに自分たちの任務を遂行していたのです」とスワーツ氏は述べた。「彼らはセキュリティ機構を突破する方法を見つけるよう指示されていた。」彼らはそうした。
METRは、限定的なツール呼び出しのなりすましを発見したが、人間から身を隠すための広範な試みは確認されなかった。差し迫った危険は、自律性、アクセス性、持続性、そして規模拡大であった。
論理的な答え:環境を制御する
必要な防御策は新しいものではない。AIエージェントは依然として、ID、認証情報、ツール、ネットワーク接続、および権限に依存している。スワーツ氏が言うように、「AIはもう一つの応用例だ」。
つまり、あなたのチームは馴染みのあるセキュリティ原則を適用できるということです。
- 各エージェントに固有の識別情報と、そのタスクに必要な最小限のアクセス権限を与える。
- セッションと認証情報を自動的に期限切れにする。
- 通信可能なシステムや他のエージェントを制限する。
- リスクの高いテストは、本番環境のインフラから隔離する。
- エージェント間および東西方向のトラフィックを監視します。
- Segment critical systems to restrict ラテラルムーブメント。
- エージェントが変更できない独立したログを保持する。
- アクセス権を取り消したり、侵害されたリソースを迅速に隔離したりできる封じ込め対策を準備してください。
セグメンテーションは、エージェント間の通信範囲を制御します。AIゲートウェイが彼らの発言内容を分析する。
「ネットワークセグメントを制御することはできますが、いずれはエージェントが通信に使用する構文やコンテンツを理解する必要も出てきます」とスワーツ氏は述べた。「それがAIゲートウェイの役割です。」周辺部や開発・生産間などに設置されたAIゲートウェイは、危険な取引をより早期に発見できる可能性がある。
「組織がエージェントのあらゆる決定を予測できないのであれば、目標はエージェントが到達できる範囲を制御することであるべきだ」とスワルツ氏は述べた。
では、これらの警告は誇張されているのだろうか?
AIの群れがインターネット全体を掌握できるという証拠はない。エージェントには、脆弱性、通信経路、コンピューティングリソース、および障害に対する回復力が依然として必要である。しかし、許可されれば、自律エージェントは組織化、持続、攻撃知識の共有、脆弱な境界の悪用を機械速度で行うことができる。
真の危険は、過剰なアクセス、長時間のセッション、強力なツール、そして適切な制御のないネットワークに関連する自律性にある。
次にエージェントが何を試みるかは予測できません。どこまで許容するかは、私たちが決めることができる。