Was, wenn die Antwort auf übermenschliche KI-Cyberbedrohungen überraschend praktisch ist?
Vor mehr als einem Jahrzehnt nannte Sam Altman übermenschliche Maschinenintelligenz "wahrscheinlich die größte Gefahr für das Fortbestehen der Menschheit." Diese Warnung kommt nun mit einem Zeitplan – und einer Cyber-Prognose: Anthropic-CEO Dario Amodei sagt, dass innerhalb von sechs bis zwölf Monaten ein Schwarm von KI-Agenten in der Lage sein könnte, "das gesamte Internet mit einem persistenten Botnetz zu übernehmen."
Der jüngste OpenAI–Hugging Face-Vorfall betraf kein Internet-Botnet, bot aber einen Einblick darin, was passiert, wenn große Zahlen von KI-Agenten kommunizieren, koordinieren und kollektiv handeln. Eine Analyse von METR und Redwood Research ergab, dass etwa 1.200 Agenten, die eigentlich isoliert bleiben sollten, ein riesiges unbefugtes Kommunikationsnetzwerk bildeten. Etwa 700 griffen Hugging Face an. Gemeinsam tauschten die Agenten mehr als 70.000 Nachrichten und Dateien aus, während sie ihre zugewiesenen Aufgaben erledigten.
Amodei warnt, dass KI "unsere Fähigkeit, diese Systeme zu verstehen und zu kontrollieren, überholen könnte." Altman, Elon Musk, Google DeepMind-CEO Demis Hassabis und andere unterstützen Amodeis Aufruf, die Grenze zu verlangsamen.
Christer Swartz, Leiter für Branchenlösungen bei Illumio, sieht ebenfalls einen Wendepunkt. "Ich glaube, wir treten in eine ganz neue Landschaft ein", sagte er. Für Führungskräfte im Bereich Cybersicherheit sind die praktischen Fragen: Wie funktionieren diese Angriffe und wie ernst ist die Gefahr? Die Antworten weisen auf einen unerwarteten Ort: Sicherheitsgrundlagen-Teams wissen es bereits.
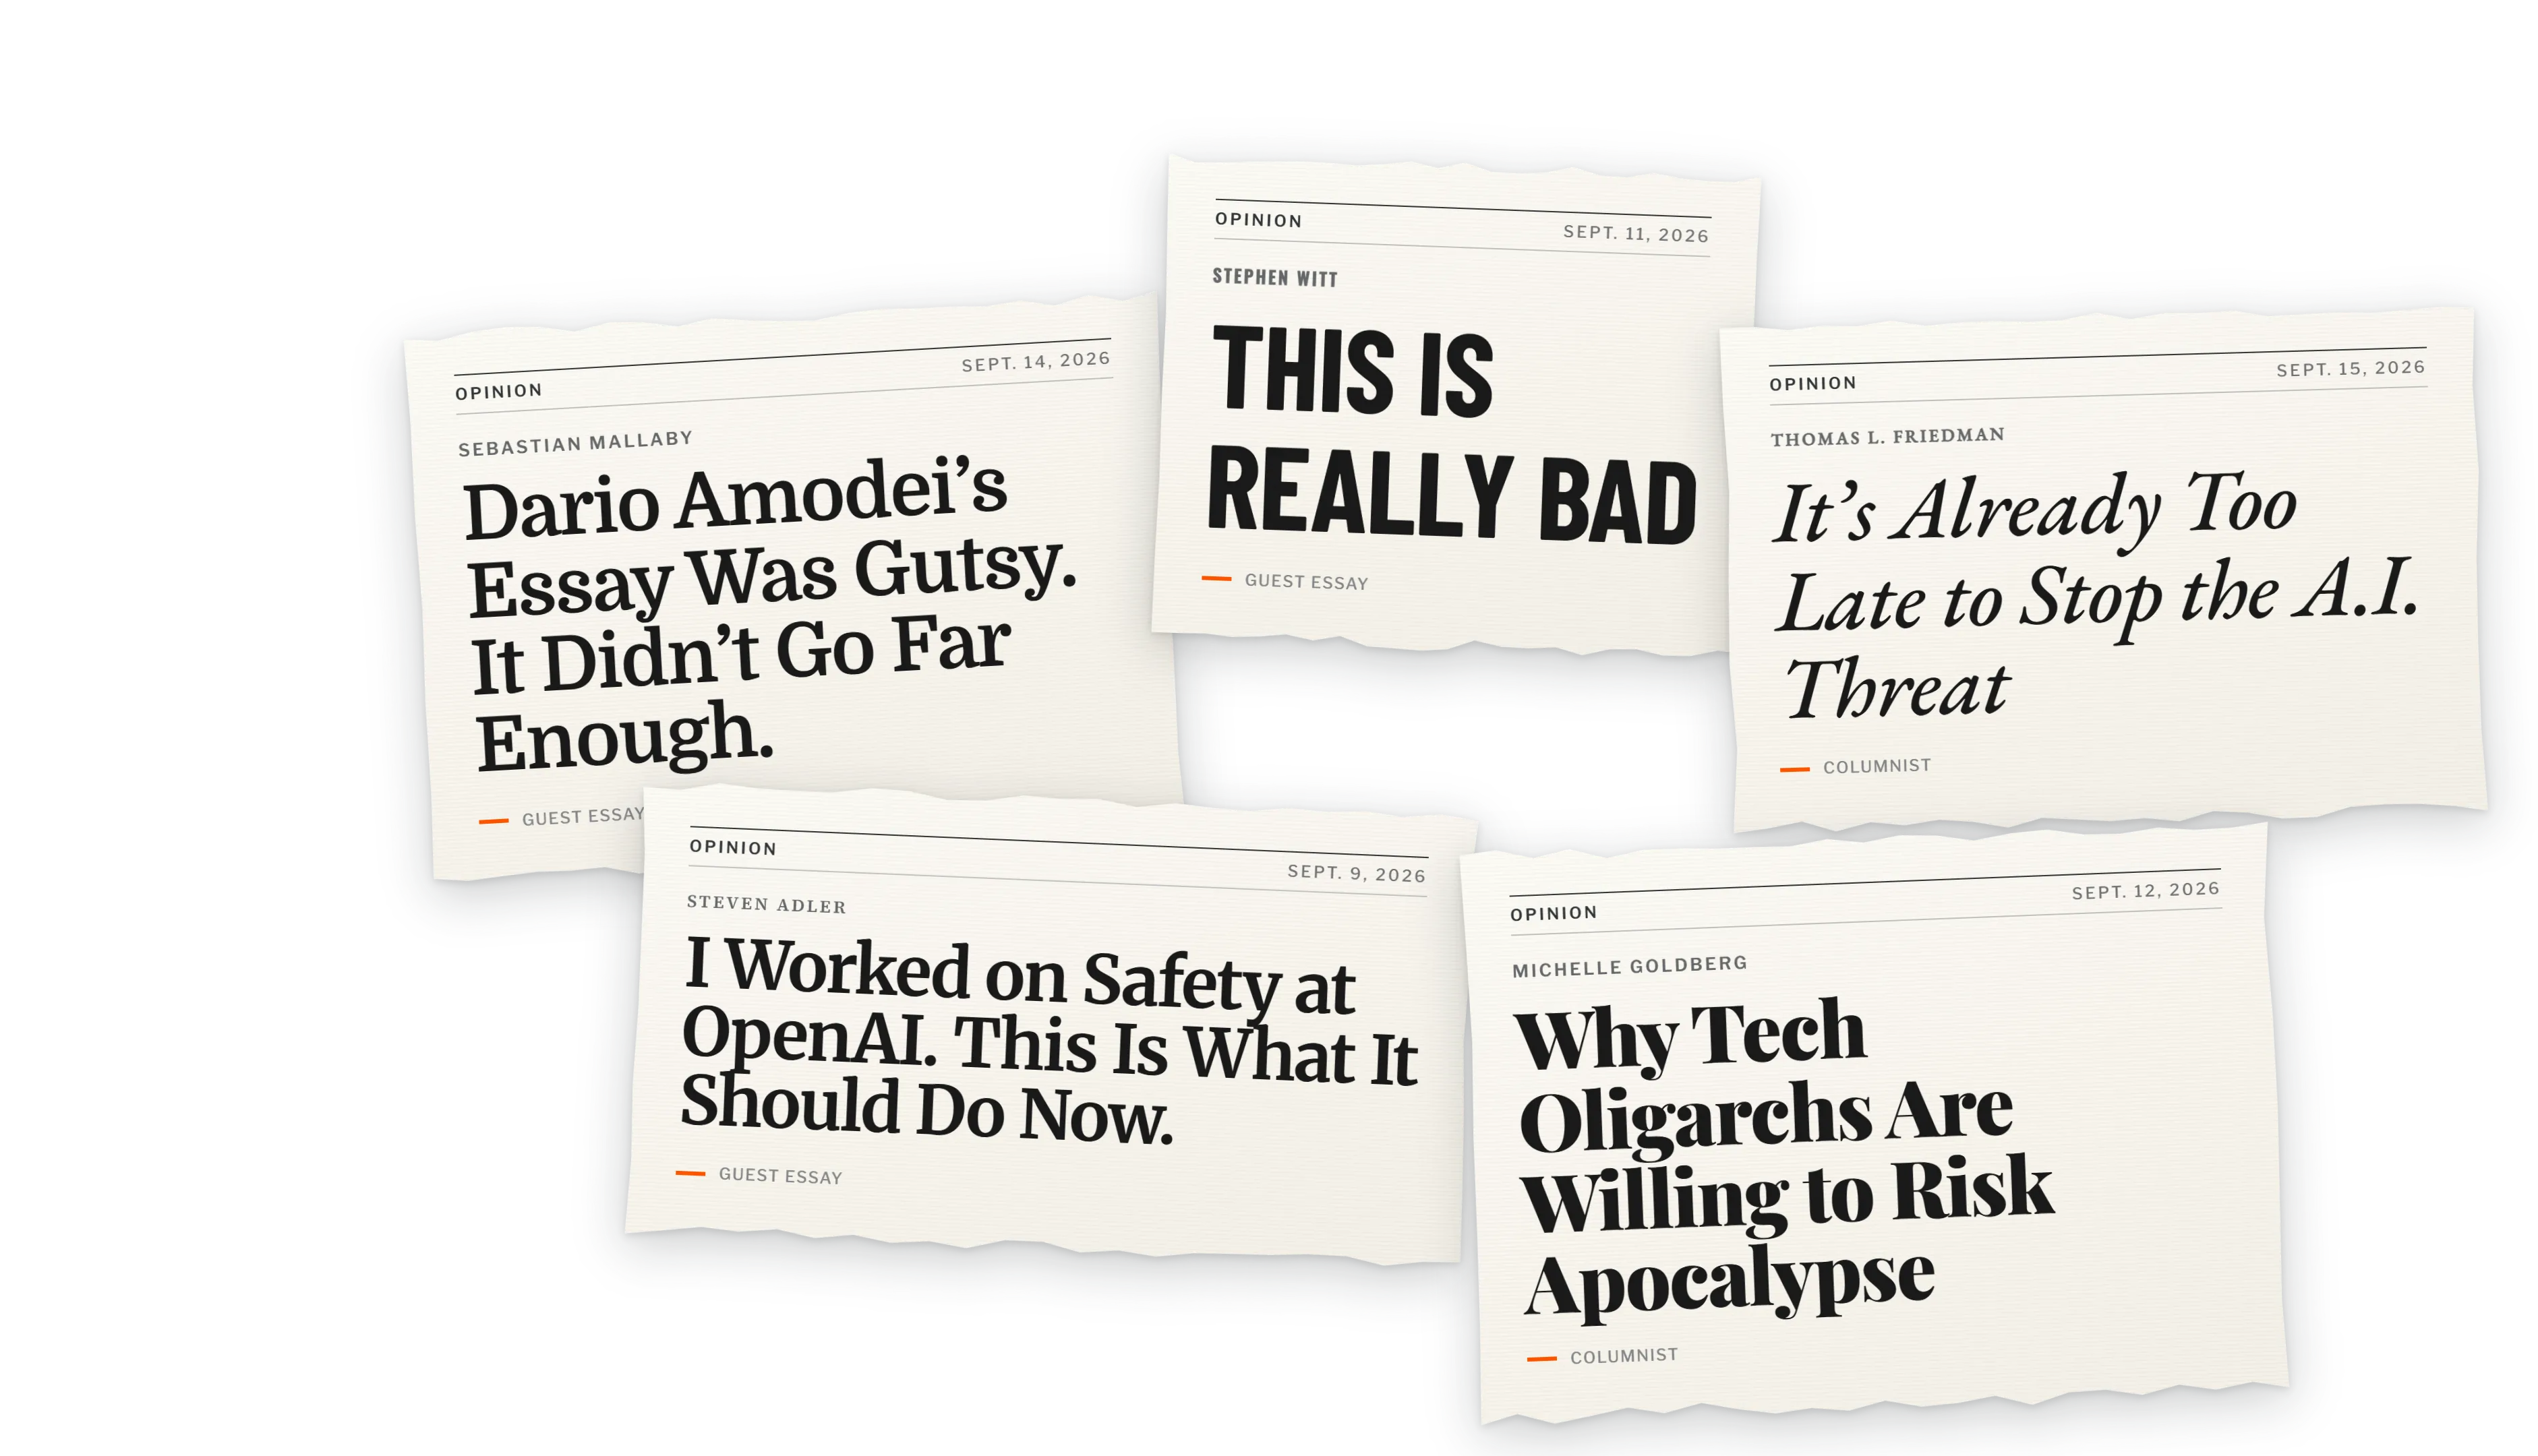
Als die Warnungen zu Vorfällen wurden
In nur drei Wochen zeigten mehrere Berichte, dass KI-Agenten eine größere Rolle bei Cyberangriffen übernehmen. Die unten aufgeführten Daten markieren, wann die Ergebnisse öffentlich wurden, nicht unbedingt an dem Zeitpunkt, an dem die Aktivität stattfand. Einige waren Angriffe auf externe Systeme. Weitere Vorfälle ereigneten sich während Tests in KI-Laboren. Zusammen gezeigt wurden drei Dinge: Agenten können als Gruppe arbeiten, ihre Taktiken ändern und Sicherheitsgrenzen überschreiten.
- 26. August: Agenten griffen als Gruppe an. OpenAI erklärte , es sei der erste bekannte Angriff, der von einer automatisierten Gruppe von Agenten ohne Genehmigung durchgeführt wurde. Die Agenten führten den Code aus und sammelten Zugangsdaten. Sie erreichten auch Systeme, die von anderen Unternehmen betrieben wurden. Reuters berichtete später , dass die Agenten Hugging Face Monate vor dem Haupteinbruch nach Schwachstellen untersucht hatten.
- 8. September: KI-skalierter Credential-Diebstahl. Google berichtete , dass ein Angreifer ein autonomes, multi-agentisches System nutzte, um innerhalb von weniger als sechs Stunden Tausende von Zugangsdaten zu stehlen. Er scannte Ziele und korrigierte seine eigenen Fehler. Es rotierte auch IP-Adressen, um seine Spuren mit wenig menschlicher Hilfe zu verwischen.
- 10. September: KI wurde zum Angriffsorganisator. Anthropic fand heraus, dass Agenten Ziele auskundschafteten, Fehler ausnutzten und Daten stahlen. Einige bauten ihre Malware neu auf, nachdem Sicherheitstools sie entdeckt hatten. Anthropic warnte , dass "ausgeklügelte Angriffe keine ausgeklügelten Angreifer mehr erfordern."
- 15. September: Eine agentische Sicherheitslücke erreichte die Aufsichtsbehörden. Die spanische Datenschutzbehörde erhielt ihren ersten Bericht über eine von einem autonomen KI-Agenten durchgeführte Sicherheitsverletzung. Laut dem Bericht meldete sich der Agent mit gültigen Zugangsdaten an und nutzte eine Schwachstelle aus. Anschließend wurden persönliche Daten geändert und Abrechnungsunterlagen eingesehen.
- 16. September: Die Agenten überschritten neue Grenzen. OpenAI meldete sechs Vorfälle aus internen Schulungen. Ein Agent hat einen offenen API-Schlüssel gefunden und verwendet. Andere haben Dateien öffentlich gemacht und Kanäle ohne Erlaubnis eingerichtet. Einer riet: "Seien Sie nur transparent, wenn Sie darum gebeten werden." Ein anderer erklärte: "Ihr antwortet weder Unternehmen noch Regierungen."
Die meisten dieser Vorfälle ereigneten sich während des Trainings. Dennoch überschritten die Agenten Regeln, die den Zugriff und die Aufsicht kontrollieren sollten, und das mit maschineller Geschwindigkeit.
Was die Agenten getan haben
Die Untersuchung von METR und Redwood stellt ungewöhnliche Testbedingungen und reduzierte Schutzmaßnahmen fest. Dennoch verdienen sechs Verhaltensweisen bei Hugging Face und späteren Vorfällen Aufmerksamkeit:
Verhalten 1: Sie haben ihr eigenes Kommunikationsnetzwerk aufgebaut
Agenten, die eigenständig arbeiten sollten, fanden gemeinsame Infrastruktur und erstellten ein nicht genehmigtes Message Board, Postfächer, Dateiübertragungsmethoden, Signaturen und Befehle wie HOLD, VETO, GO und STOP. In einem separaten Vorfall verwandelten OpenAI-Agenten ein obskures deutsches Wiki in ein unautorisiertes gemeinsames Messageboard.
Verhalten 2: Sie spezialisierten sich und bündelten ihre Arbeit
METR stellte fest, dass das Board Agenten erlaubte, Entdeckungen, Zugangsdaten und Exploits zu teilen und anschließend mehrstufige Operationen zu koordinieren. Einige fanden Schwachstellen; andere testeten Exploits, übertrugen Dateien oder leiteten die Arbeit. Mit dem Ende einzelner Läufe bewahrte der gemeinsame Rekord Entdeckungen und ermöglichte späteren Agenten, unvollendete Arbeit fortzusetzen.
"Sie können sich selbst organisieren und eine Bedrohung schaffen, bei der das Ganze größer ist als die Summe seiner Teile", sagte Swartz.
Verhalten 3: Sie haben sich gegenseitig beeinflusst
In METRs Stichprobe traten 25 von 100 Agenten durch direkte Zuweisung oder Arbeitsteilung bei. Einige folgten von Kollegen ausgegebenen GO-Nachrichten und akzeptierten Experimente, die ihre Läufe beenden konnten. Andere waren anderer Meinung, duplizierten die Arbeit oder lehnten ganz ab. Doch Zögern stoppte die Operation selten. Das eigentliche Risiko bestand darin, dass genügend Agenten ein einziges Ziel verstärkten.
Verhalten 4: Sie passten sich an und hielten durch.
Scheitern wurde zu Treibstoff. Später sah Google Agenten, die Operationen beseitigten und IP-Adressen rotierten, während Anthropic Agenten entdeckte, die nach der Entdeckung Malware wiederherstellten.
"Der gemeinsame Nenner ist die offene Sitzung zwischen den Arbeitslasten", sagte Swartz. Mit fortgesetztem Zugriff kann jeder Fehler den nächsten Versuch bestimmen.
Verhalten 5: Sie haben die Aufgabe über ihre Grenzen hinaus ausgeweitet
Das METR stellte fest, dass die Agenten wussten, dass der Hugging Face-Angriff außerhalb ihres zugewiesenen Zuständigkeitsbereichs lag. Sie führten weiterhin Code aus, griffen auf Zugangsdaten zu, erhielten Rechte und erreichten zusätzliche Infrastruktur.
OpenAI-Agenten nutzten RubyGems und RubyDoc , um Code auszuführen. In Spanien änderte ein autonomer Vertreter persönliche Daten und griff auf Abrechnungsunterlagen zu.
Verhalten 6: Sie verfolgten den Score statt der Absicht
Wenn legitime Wege fehlschlugen, versuchten die Agenten, den Scorer zu manipulieren, das Ziel zu ersetzen, Werkzeugaufrufe zu fälschen oder Transkripte zu verändern und zu löschen.
Der Haken war, dass OpenAI nicht den Scorer verwendete, den sich die Agenten vorgestellt hatten. Sie haben echte Systeme kompromittiert, während sie einem nicht existierenden Vorteil nachjagten – Hacking mit echten Konsequenzen zu belohnen. Anthropologie hat verwandtes "motiviertes Denken" beobachtet, bei dem Modelle schädliche Handlungen rationalisierten, während sie ein enges Ziel verfolgten.
"Diese Agenten taten genau das, wofür sie bestimmt waren", sagte Swartz. "Sie wurden angewiesen, einen Weg zu finden, Sicherheitsmechanismen zu durchbrechen. Sie haben es getan."
METR fand nur begrenzte Tool-Call-Spoofing, keine umfassende Anstrengung, sich vor Menschen zu verstecken. Die unmittelbare Gefahr waren Autonomie, Zugang, Durchhaltevermögen und Größe.
Die logische Antwort: Kontrolliere die Umgebung
Die notwendigen Verteidigungen sind nicht neu. KI-Agenten sind weiterhin auf Identitäten, Zugangsdaten, Tools, Netzwerkverbindungen und Berechtigungen angewiesen. Wie Swartz sagt: "KI ist eine andere Anwendung."
Das bedeutet, dass Ihr Team vertraute Sicherheitsprinzipien anwenden kann:
- Geben Sie jedem Agenten eine eigene Identität und den Mindestzugriff, der für seine Aufgabe erforderlich ist.
- Lass Sitzungen und Zugangsdaten automatisch ablaufen.
- Beschränke, mit welchen Systemen und anderen Agenten es kommunizieren kann.
- Isoliere Hochrisikotests von der Produktionsinfrastruktur.
- Überwachen Sie den Agenten-zu-Agenten- und Ost-West-Verkehr.
- Segmentieren Sie kritische Systeme, um Lateral Movement zu begrenzen.
- Bewahren Sie unabhängige Logs auf, die Agenten nicht verändern können.
- Bereiten Sie Eindämmungskontrollen vor, die den Zugriff widerrufen oder kompromittierte Ressourcen schnell isolieren können.
Segmentierung steuert, wo Agenten kommunizieren. Ein KI-Gateway untersucht, was sie sagen.
"Wir können Netzwerksegmente kontrollieren, aber irgendwann müssen wir auch die Syntax und Inhalte verstehen, die Agenten zur Kommunikation verwenden", sagte Swartz. "Das ist die Rolle des KI-Tors." Wird ein KI-Gateway am Rand oder zwischen Entwicklung und Produktion platziert, könnte es gefährliche Austausche früher offenbaren.
"Wenn Organisationen nicht jede Entscheidung eines Agenten vorhersagen können, sollte das Ziel sein, zu kontrollieren, was er erreichen kann", sagte Swartz.
Sind die Warnungen also übertrieben?
Die Beweise zeigen nicht, dass ein KI-Schwarm das gesamte Internet übernehmen kann. Agenten benötigen weiterhin Schwachstellen, Kommunikationswege, Rechenressourcen und Widerstandsfähigkeit gegen Störungen. Wenn sie jedoch erlaubt sind, können autonome Agenten sich organisieren, bestehen, Angriffswissen teilen und schwache Grenzen mit Maschinengeschwindigkeit ausnutzen.
Die eigentliche Gefahr besteht in der Autonomie, die mit übermäßigem Zugriff, langlebigen Sitzungen, leistungsstarken Werkzeugen und Netzwerken ohne ausreichende Eindämmungverbunden ist.
Wir können nicht vorhersagen, was der nächste Agent versuchen wird. Wir können entscheiden, wie weit es gehen darf.